Un agent GPT-4.1 réussit 77,4 % des exécutions mais ne répète que 53,0 % des tâches
Tandis que les fournisseurs commercialisent des harnais d'agents sans métrique de fiabilité, IBM Research mesure un écart de consistance de 24,4 points entre succès moyen et exécution répétée.
Cette quinzaine, trois acteurs commerciaux ont packagé la couche censée rendre un agent IA fiable : un cadre méthodologique de cabinet de conseil, une API louée, un standard d’identité pour les paiements. Le seul groupe qui a réellement mesuré la fiabilité a découvert un écart de 24,4 points entre le score qu’un agent affiche en moyenne et le score qu’on peut lui faire confiance de répéter.
Le harnais a un nom, et toujours aucun chiffre
Tout agent s’exécute au sein d’une structure plus vaste que le modèle lui-même : une boucle qui gère le contexte, appelle les outils et détermine le moment où une tâche est achevée. L’industrie a désormais un mot pour désigner cet ensemble : le harnais (harness).
Le BCG a publié cette semaine un cadre méthodologique identifiant cinq composants d’un harnais : Spécifications (Specs), Constitution, Tableau de bord (Control Panel), Hub de contexte (Context Hub), et Barrières de qualité (Quality Gates), chacun mis en correspondance avec un pan d’un système d’exploitation informatique, du manifeste applicatif à la gestion des permissions. Les barrières de qualité se déclinent, selon le cabinet, en quatre types : automatisées pour intercepter les erreurs de programmation, d’évaluation lorsqu’un agent critique inspecte un agent travailleur, étapes humaines où un responsable désigné valide le résultat, et réglementaires pour la conformité. Le cadre formalise le contenu et la gouvernance d’un harnais, sans jamais associer la moindre mesure chiffrée à la tenue effective d’une barrière donnée lorsque la même tâche est exécutée deux fois.
Cette absence est fondamentale : une barrière de qualité constitue, au fond, une promesse de consistance — l’assurance que cette étape sera correctement vérifiée et ce livrable validé. Nommer une barrière ne revient pas à mesurer ce qu’elle est censée prévenir.
Trois manières d’acheter la couche censée apporter la fiabilité
Le BCG préconise de développer son harnais en interne, sur mesure pour les processus propres de l’entreprise : « build, don’t buy », car le contexte, les signaux de qualité et la mémoire institutionnelle ne s’achètent pas sur étagère. C’est une première réponse à la question de savoir à qui appartient le harnais. OpenAI, quelques jours plus tôt, a défendu la démarche inverse.
L’API Agents d’OpenAI, ouverte en bêta publique le 10 septembre, met à disposition des développeurs le même harnais que celui qui propulse Codex et ChatGPT for Work, maintenu directement par OpenAI plutôt que par le client. Le développeur choisit uniquement l’environnement d’exécution — un bac à sable managé par OpenAI, sa propre infrastructure ou l’un des neuf partenaires référencés — et ne paie que pour les tokens et l’usage des outils. Chaque nouvelle version de modèle apporte des perfectionnements du harnais que le développeur n’a jamais à concevoir lui-même.
Cet arbitrage — construire en interne ou louer auprès du laboratoire — est précisément ce que je recommanderais de peser avant de confier la gestion du harnais à OpenAI via cette nouvelle API. La location s’avère un choix pertinent si l’objectif est d’aboutir rapidement sans consacrer un temps excessif à l’optimisation fine de la tâche. En revanche, si l’équipe dispose d’une réelle expertise, elle a tout intérêt à personnaliser elle-même certains pans de ce harnais, à commencer par la gestion de la mémoire.
Une troisième approche émerge totalement en dehors du secteur logiciel. Visa, Mastercard et Ant International ont annoncé le 10 septembre l’initiative conjointe Know Your Agent, destinée à permettre aux réseaux de cartes, aux portefeuilles électroniques et aux plateformes marchandes de vérifier l’identité d’un agent d’achat IA avant qu’il ne finalise une transaction. Chacun exploite déjà son propre protocole — Trusted Agent Protocol pour Visa, Verifiable Intent pour Mastercard, Agentic Mobile Protocol pour Ant International — et les trois acteurs n’ont pour l’instant convenu que d’explorer des principes partagés. Know Your Agent ne constitue pas encore une norme interopérable : il s’agit de trois acteurs historiques convergeant vers l’idée qu’un agent, à l’instar d’un porteur de carte, requiert une identité vérifiable. Le communiqué commun anticipe lui-même que les agents IA orchestreront entre 3 000 et 5 000 milliards de dollars de commerce mondial d’ici 2030. PYMNTS, relayant l’annonce, y ajoute sa propre estimation selon laquelle des contrôles d’identité obsolètes coûtent aux entreprises près de 100 milliards de dollars par an en fraudes, faux refus et abandons d’achats.
Le chiffre unique qui révèle la tenue d’un harnais
Aucune des trois offres susmentionnées ne quantifie la fiabilité. IBM Research l’a fait, dans une publication sur Hugging Face parue le 15 septembre qui formalise ce qu’elle nomme l’écart de consistance (consistency gap).
La plupart des benchmarks d’agents évaluent le score moyen (Mean@k) : exécuter une tâche plusieurs fois et faire la moyenne des réussites. C’est le chiffre affiché sur tous les classements, qui renseigne sur le niveau moyen d’un agent. Il ne répond pas à la question essentielle avant tout déploiement en production : l’agent réussira-t-il encore si la même requête lui est soumise une seconde fois ? Pour y répondre, IBM a mesuré le Pass^k, c’est-à-dire la proportion de tâches résolues sur la totalité des k exécutions répétées.
Sur le benchmark AppWorld (test_normal, 168 tâches), un agent ReAct articulé autour de GPT-4.1 affiche un Mean@5 de 77,4 % — une moyenne robuste —, mais un Pass^5 de seulement 53,0 %. Près d’un quart du benchmark est constitué de tâches que l’agent réussit parfois et échoue d’autres fois, sans la moindre variation dans l’énoncé ; l’évaluation tournait à température 0,0, excluant ainsi tout bruit d’échantillonnage. IBM qualifie cet écart de 24,4 points d’écart de consistance et le décrit comme orthogonal à la capacité brute : un modèle plus puissant rehausse la moyenne sans nécessairement combler la disparité. C’est le cadrage théorique propre à IBM, et la mesure concerne une équipe, un benchmark et un modèle donnés.
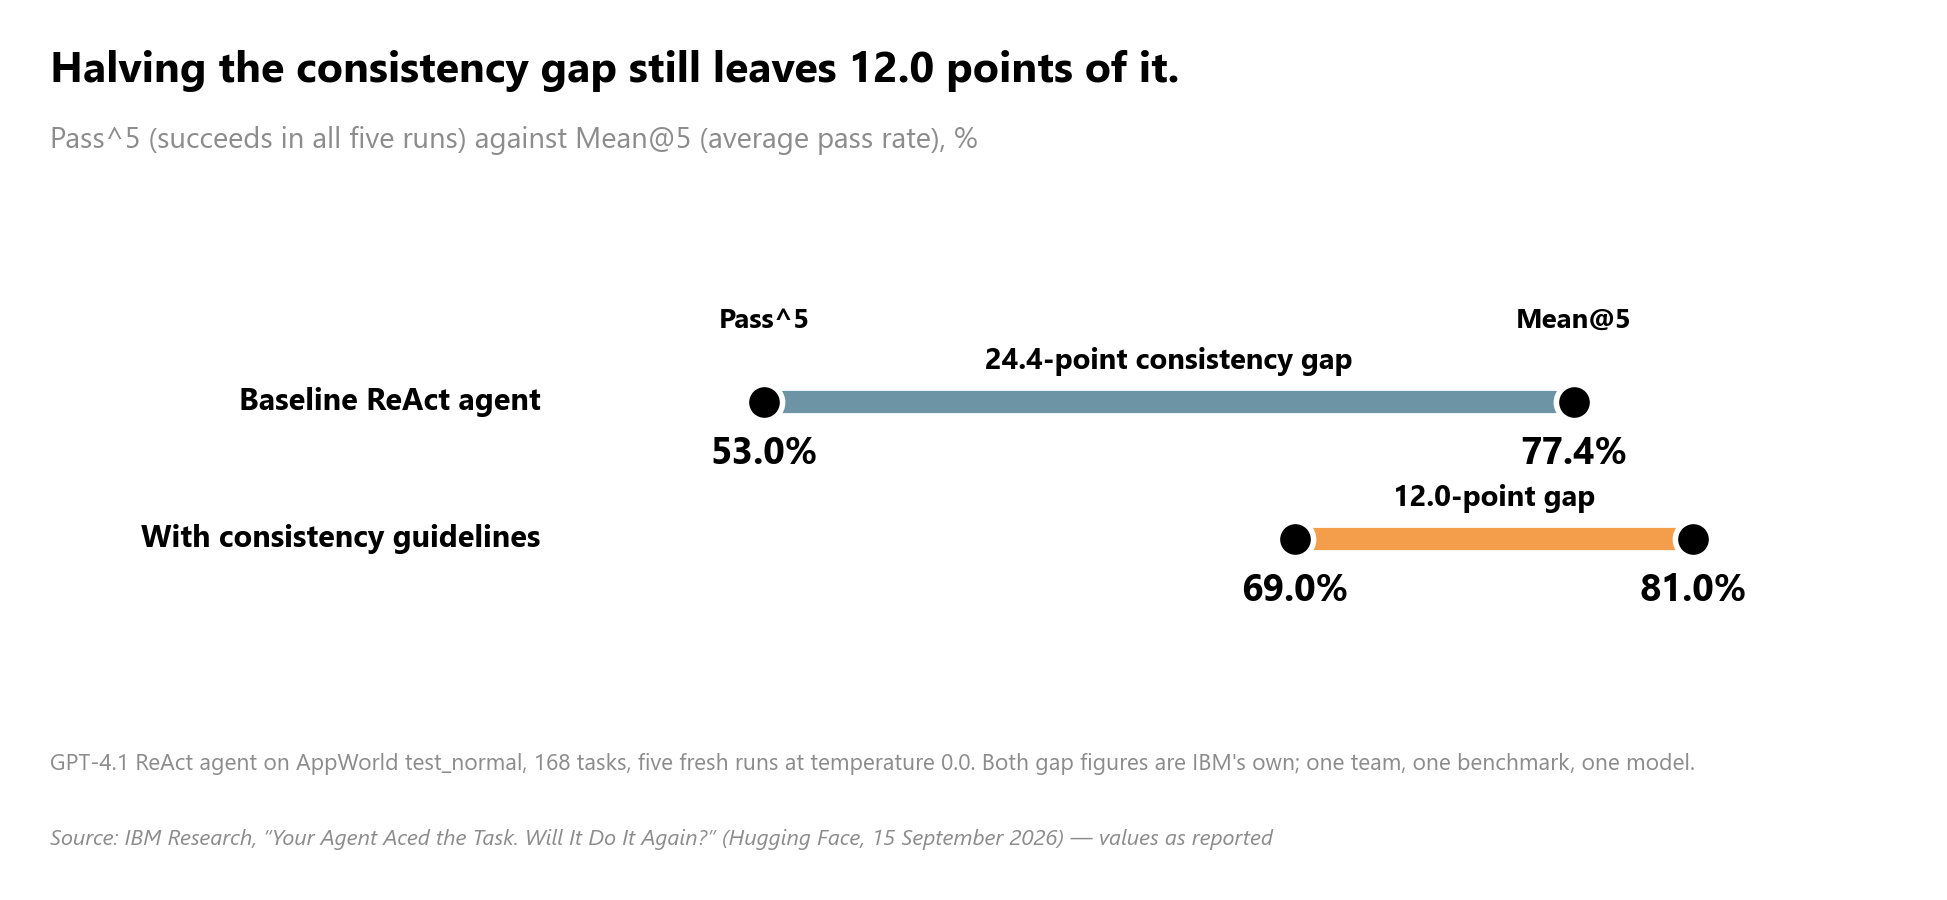
IBM ne s’est pas arrêtée au diagnostic. Son outil Consistency Analyzer rééchantillonne les points de décision d’une exécution pour repérer ceux qui s’apparentent à un tirage à pile ou face, puis transforme les bifurcations risquées en directives réutilisables. Leur application a réduit l’écart global d’environ moitié, passant de 24,4 à 12,0 points, le Pass^5 grimpant à 69,0 % et le Mean@5 à 81,0 %. Sur un modèle plus modeste, gpt-oss-120b, le même correctif a fait progresser le Pass^5 de 10,1 % à 16,1 % sur la même tâche. L’écart se resserre ; selon les données d’IBM, il en subsiste tout de même 12,0 points.
J’ai moi-même constaté une manifestation concrète de cet écart, sans benchmark formel. Nous calibrions les paramètres de recherche d’un scraper en testant les combinaisons de mots-clés les plus concluantes, et nous avions arrêté une liste bien définie. Au bout d’un certain temps, l’agent s’est mis à mélanger les mots-clés, puis à intervertir complètement les langues. Je ne m’en suis aperçu qu’en examinant moi-même les logs à l’œil nu.
Ce que l’écart coûte à ceux qui pilotent le harnais
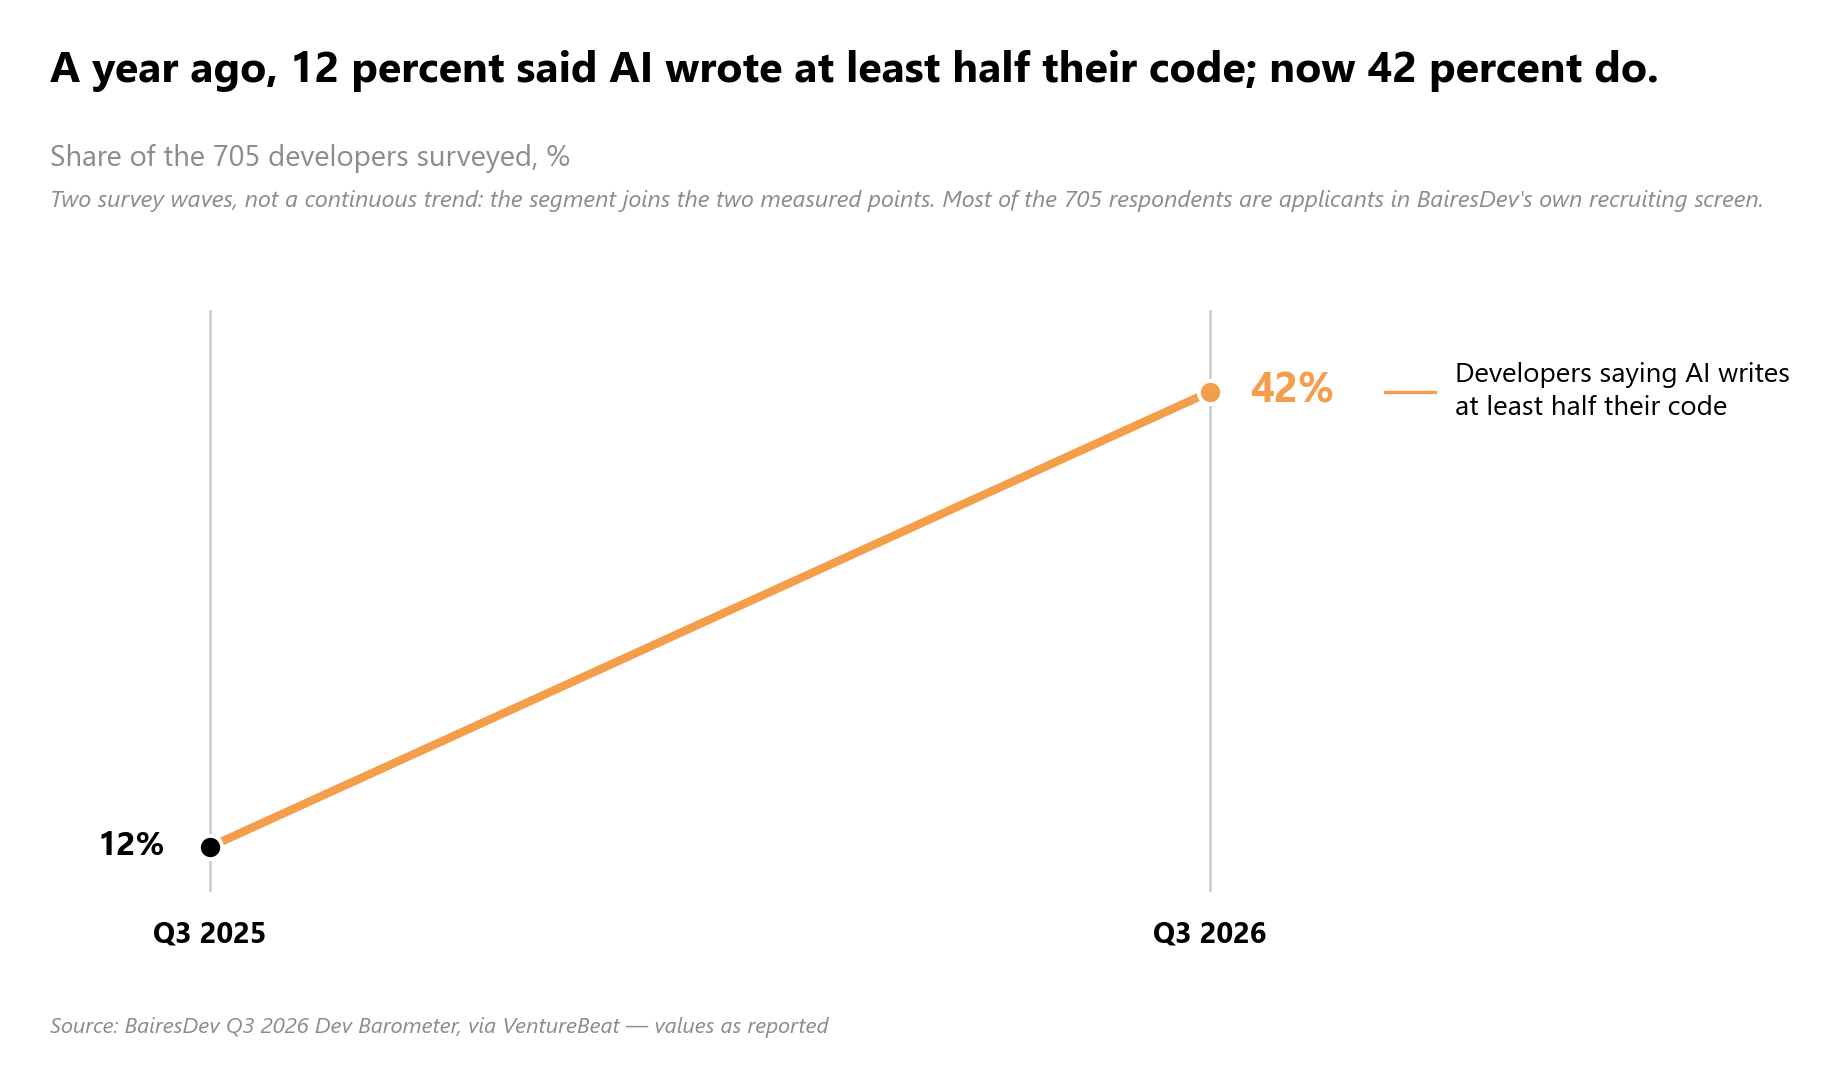
Le Baromètre Développeurs T3 2026 de BairesDev, mené auprès de 705 développeurs et 41 directeurs techniques dans plus de 60 pays, révèle que 42 % des développeurs affirment désormais que l’IA rédige au moins la moitié de leur code, contre seulement 12 % au troisième trimestre 2025. Ces 705 répondants ne sont pas de simples salariés en poste : la majorité, précise BairesDev, est issue de son propre vivier de recrutement. Les données développeurs proviennent de cet échantillon ; les 41 directeurs techniques constituent un groupe distinct, nettement plus restreint.
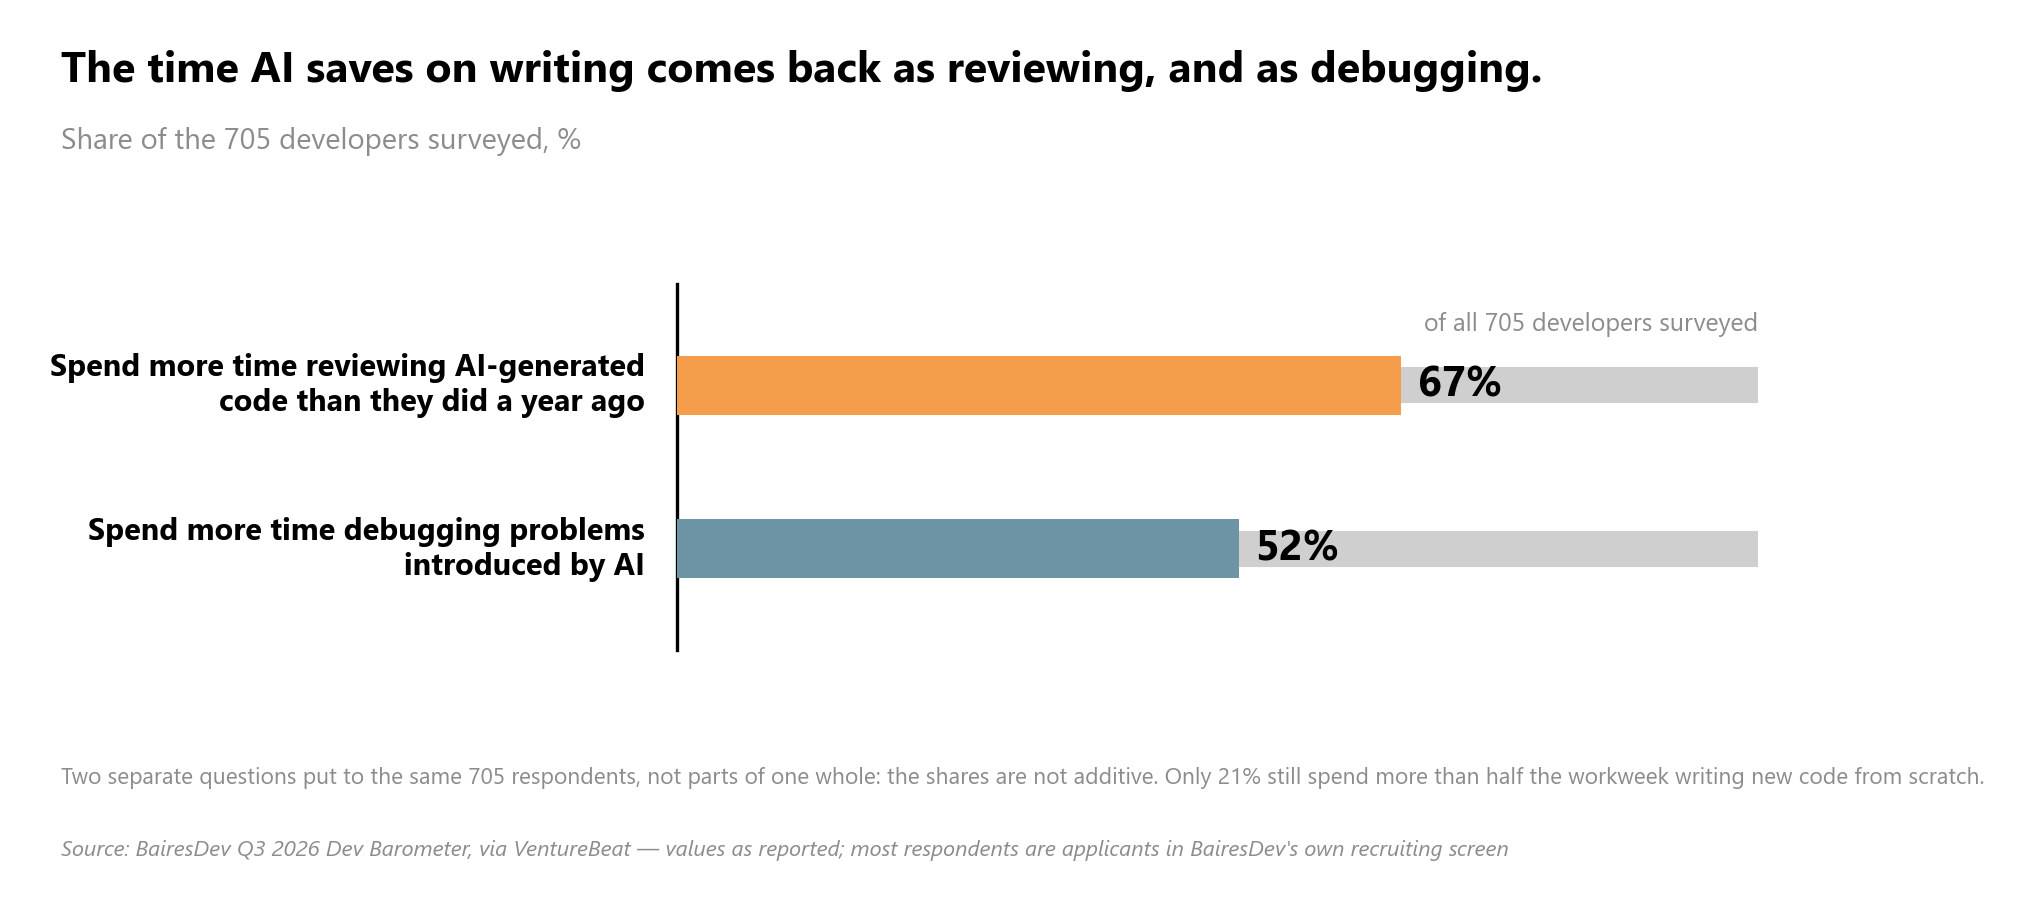
Le temps économisé sur l’écriture du code ne s’est pas transformé en capacité disponible. Soixante-sept pour cent des développeurs passent davantage de temps à relire le code produit par l’IA qu’un an auparavant, 52 % consacrent plus de temps à déboguer les anomalies introduites, et seuls 21 % passent encore plus de la moitié de leur semaine à rédiger du code neuf à partir de zéro. Cette réallocation des efforts illustre l’écart d’IBM vu depuis l’autre côté du harnais : un résultat qui semblait parfait au premier passage n’est pas un résultat auquel une équipe peut se fier les yeux fermés.
Les volumes sous-jacents sont considérables. À la mi-août, le chercheur médian d’OpenAI consommait plus de 600 dollars par jour d’inférence d’agents de codage aux tarifs d’API, le 90e percentile dépassant les 7 000 dollars. Son organisation de recherche déploie désormais 3,1 jours-agents d’effort pour chaque journée de travail humain. 1Password, qui déploie Codex sur sa chaîne de livraison logicielle, fait état d’un gain de productivité de près de 21 % pour son groupe d’utilisateurs clés et d’une réduction de près de 11 % du délai médian de revue des pull requests. Aucun de ces chiffres n’est audité de manière indépendante : le cas d’usage 1Password est publié par OpenAI et non par 1Password, et les chiffres d’OpenAI décrivent sa propre organisation interne. Les deux convergent vers le même constat : l’activité des agents derrière ces volumes d’heures est déjà massive, et continue de croître.
Ce second niveau de contrôle est également la démarche pratique que j’ai adoptée, loin des scores de benchmarks. J’utilise l’IA pour relire le code produit, n’ayant pas le temps matériel de tout relire manuellement. Le meilleur levier consiste à structurer l’environnement de travail pour préserver l’alignement entre ma vision et ce que l’IA construit : en posant de multiples questions de conception, et en incitant l’IA à me poser un maximum de questions préalables.
Ce que cela signifie
Le BCG mentionne les barrières de qualité parmi cinq piliers sans leur associer de métrique. IBM nomme une seule barrière, la consistance, et avance un chiffre : 24,4 points d’écart, réductibles à 12,0 points avec les bonnes directives, sur un benchmark, un modèle et selon la mesure d’une équipe. Cette asymétrie résume l’actualité de cette quinzaine : les fournisseurs qui vendent un harnais — cadre méthodologique, API louée ou standard d’identité — commercialisent des briques fonctionnelles. L’équipe qui mesure si l’ensemble fonctionne est un laboratoire de recherche publiant un outil de diagnostic sur un blog.
Les résultats clients mis en avant par le BCG dans son document — temps dédié aux clients triplé pour les conseillers, gains d’efficacité multipliés par cinq, vitesse de déploiement accrue de 50 % — relèvent de déclarations internes relatives à ses propres missions, et non d’une référence évaluée de façon indépendante. Ils constituent un argumentaire, non la démonstration de l’efficacité d’un harnais.
Cet écart entre ce qui est nommé et ce qui est mesuré suscite également des réserves quant à la grille du BCG. Leurs cinq composants recoupent relativement bien les huit leviers que nous mobilisons dans notre propre méthodologie d’IA agentique, et ils disposent manifestement d’une approche cohérente pour les articuler. Mais un harnais dépend intimement de l’usage et du contexte dans lequel il est déployé, et ne saurait être standardisé comme leur cadre le présente. Ce qu’ils ont conçu s’apparente moins à un harnais figé qu’à une matrice de décision, ce qui se rapproche d’ailleurs de notre propre construction.
Acheter un harnais revient aujourd’hui à choisir entre cinq blocs conceptuels, une boucle managée ou un protocole d’identité que trois multinationales ont simplement convenu d’étudier. Mesurer un harnais exige de tester cinq itérations consécutives de la même tâche et de publier le chiffre qui ne flatte pas la moyenne. Tant que les vendeurs ne publieront pas ce second indicateur, un harnais affichant des barrières de qualité sur sa plaquette commerciale et un harnais dont la consistance a été rigoureusement éprouvée demeureront, vus de l’extérieur, strictement indiscernables.
Sources
- Harness Engineering: The Operating System for Agentic AI (BCG Publications)
- Introducing the Agents API (OpenAI News)
- Visa and Mastercard Team With Ant on Know Your Agent Framework (PYMNTS)
- Your Agent Aced the Task. Will It Do It Again? (Hugging Face Blog / IBM Research)
- The Share of Developers Using AI to Write Half or More Code Jumped From 12% to 42% YOY (VentureBeat)
- Research Acceleration: The View Inside OpenAI (OpenAI News)
- 1Password Increases Engineering Productivity 21% With Codex (OpenAI News)