À 30 000 fusions de code par jour, Anthropic voit le jugement devenir un goulot d'étranglement
Meta, Cognition, Anthropic et Bain décrivent chacun des agents d'IA qui déplacent le goulot d'étranglement du logiciel de l'écriture du code vers la relecture, le jugement et l'exploitation. Les équipes répondent en intégrant les contrôles à la boucle même de l'agent.
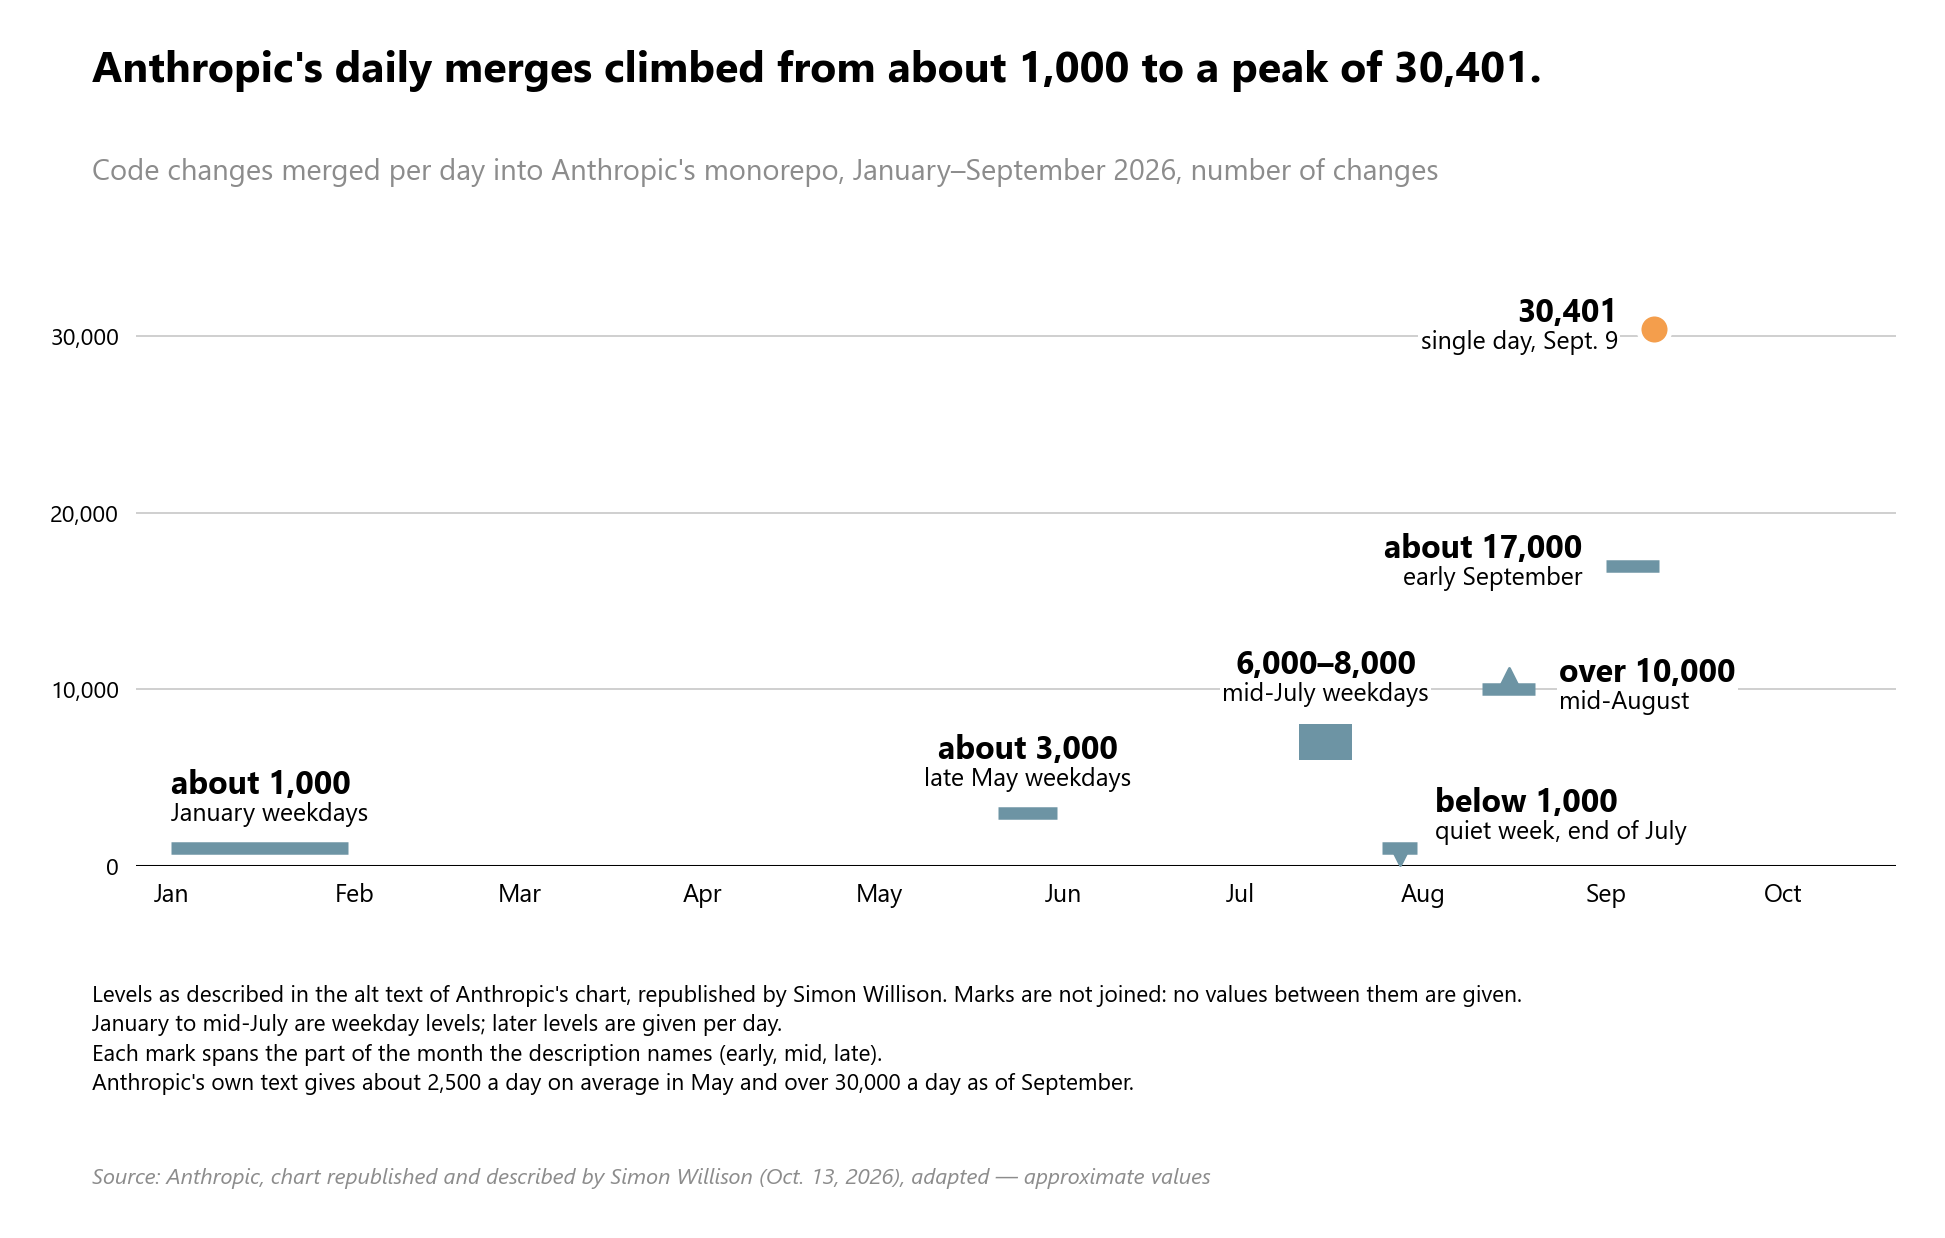
En septembre, Anthropic fusionnait plus de 30 000 modifications de code par jour dans son dépôt unique (monorepo), contre environ 2 500 en mai. Cette semaine, Meta, Cognition et Anthropic elle-même ont décrit ce que le code écrit par des agents fait au travail d’ingénierie. Tous trois s’accordent sur un point : écrire du code a cessé d’être la partie difficile, et juger puis vérifier ce que produisent les agents a pris sa place.
Pourquoi un code bon marché fait de la vérification l’étape rare
Un code peut compiler, s’exécuter et sembler complet tout en faisant la mauvaise chose. OpenAI en a donné cette semaine un exemple précis, dans un billet sur la migration de programmes COBOL. L’arithmétique à virgule fixe de COBOL supprime les décimales en trop, sauf si un arrondi est explicitement demandé : une réécriture qui arrondit peut donc tourner sans erreur tout en produisant des résultats financiers différents. OpenAI précise que mettre de telles migrations en production exige toujours une relecture experte et des tests confrontés aux règles métier et aux dépendances du système.
L’équipe Forum de Meta, qui a construit une nouvelle application Facebook Groups en confiant à l’IA une grande partie de l’implémentation courante, nomme le cas général. Sans vérification, écrit l’équipe, le code généré par l’IA est « un résultat plausible dont personne n’a confirmé qu’il fonctionne réellement », qu’un ingénieur doit ensuite lire, déboguer et souvent jeter. Mis côte à côte, les deux exemples décrivent une asymétrie. Un agent rend la production d’un code plausible presque gratuite, alors que confirmer ce code demande toujours des tests que quelqu’un doit écrire et un jugement que quelqu’un doit exercer.
C’est le volume qui transforme cette asymétrie en goulot d’étranglement. Dans un billet sur sa gestion de versions, cité par le développeur Simon Willison, Anthropic fait état d’environ 2 500 modifications fusionnées par jour en mai 2026 et de plus de 30 000 par jour en septembre. Son graphique, tel que Willison l’a republié, culmine à 30 401 le 9 septembre. Ces chiffres comptent des modifications fusionnées. Ils ne disent rien de la taille de chaque modification ni du temps que quiconque a passé à la lire.
Les éditeurs constatent la même accélération chez eux. Russell Kaplan, cofondateur et président de Cognition, l’entreprise derrière l’agent de programmation Devin, a déclaré à McKinsey que Devin écrit désormais environ 95 % du code que Cognition livre, et que la production totale de code de l’entreprise a été multipliée par sept environ en six mois. Ces chiffres ne viennent que de l’éditeur. Kaplan rapporte aussi que, lorsque Cognition l’a testé, le volume de code s’est révélé un mauvais prédicteur de l’effort d’ingénierie qu’exigeait une tâche.
Quatre récits du déplacement du goulot
Quatre sources disent où se situe désormais la contrainte. Elles s’accordent sur le fait qu’elle s’est déplacée, et chacune désigne un point d’arrivée différent.
Pour l’équipe Forum de Meta, elle s’est reportée sur la relecture. Des signaux faibles, écrit l’équipe, ne suppriment pas la contrainte ; ils « la déplacent de l’écriture du code vers la relecture d’un code qui a l’air terminé et ne l’est pas ».
Pour Kaplan, elle s’est reportée sur le choix et la vérification. Parce que les équipes dirigent et relisent désormais bien plus de production par personne, a-t-il expliqué à McKinsey, la contrainte passe de la vitesse à laquelle les gens écrivent du code à leur capacité à décider ce qui vaut la peine d’être construit et à vérifier que c’est correct.
Pour Anthropic, elle s’est reportée sur l’attention. Un rapport que l’entreprise a publié sur ses propres effectifs, couvert par TechCrunch, suggère que « l’attention et le jugement humains » deviennent un goulot d’étranglement, parce que Claude produit un déluge de texte que des personnes doivent lire et organiser.
Pour Bain, le cabinet de conseil, elle s’est reportée en aval, sur l’exploitation. Dans une enquête menée auprès de près de 300 responsables technologiques et d’ingénierie, Bain décrit un paradoxe de la fiabilité : l’IA comprime le coût de construction des logiciels mais peut gonfler celui de leur exploitation, à moins que l’exploitation ne soit repensée en parallèle. Si l’on ne cherche que la vitesse, écrit Bain, le goulot d’étranglement passe « du clavier de l’ingénieur au bipeur ». Dans l’enquête, les plus grands gains mesurables de l’IA à ce jour portent sur la vitesse et le débit, et les dirigeants attendent une amélioration de près de 150 % dans les un à deux ans qui viennent. Le gain qu’ils anticipent en résilience opérationnelle est le plus faible de tous les indicateurs mesurés par Bain. Près des deux tiers des dirigeants placent l’IA appliquée à l’écriture, aux tests et à la relecture du code au premier rang des leviers de productivité, tandis que l’observabilité et l’automatisation de la gestion des incidents figurent près du bas du classement, citées par environ un sur cinq.
Même la vitesse n’est pas acquise : Kaplan cite WPP, qui avait déployé un assistant de programmation par IA auprès de 500 ingénieurs sans voir bouger aucun de ses indicateurs de livraison. Tous ces récits sont des autodescriptions ou des enquêtes d’opinion, et aucun n’est une mesure extérieure. Ce qu’ils ont en commun, c’est une direction, et plusieurs de ces mêmes équipes décrivent les contrôles qu’elles construisent désormais autour.
Le contrôle écrit en code : barrières, crochets et routeur minimal
Le contrôle que décrivent ces équipes est de deux sortes. La première est déterministe : une règle écrite en code ordinaire, qui donne la même réponse à chaque fois, là où un modèle de langage raisonne de façon probabiliste et peut répondre différemment d’une exécution à l’autre. L’équipe des pipelines de données de Meta a construit son système d’agents autour de cette frontière.
Les agents de l’équipe ajoutent des colonnes de données aux systèmes de recommandation de Meta, une tâche qui exige des modifications de code coordonnées dans trois dépôts, trois langages de programmation et jusqu’à six étapes de pipeline. Sa première conception reposait sur un agent unique qui savait tout. Elle fonctionnait en démonstration ; en production, écrit Meta, l’agent « s’est mis à halluciner ». Le remède n’a été ni de meilleures instructions ni une fenêtre de contexte plus grande. Il a consisté à donner moins à faire à l’agent central.
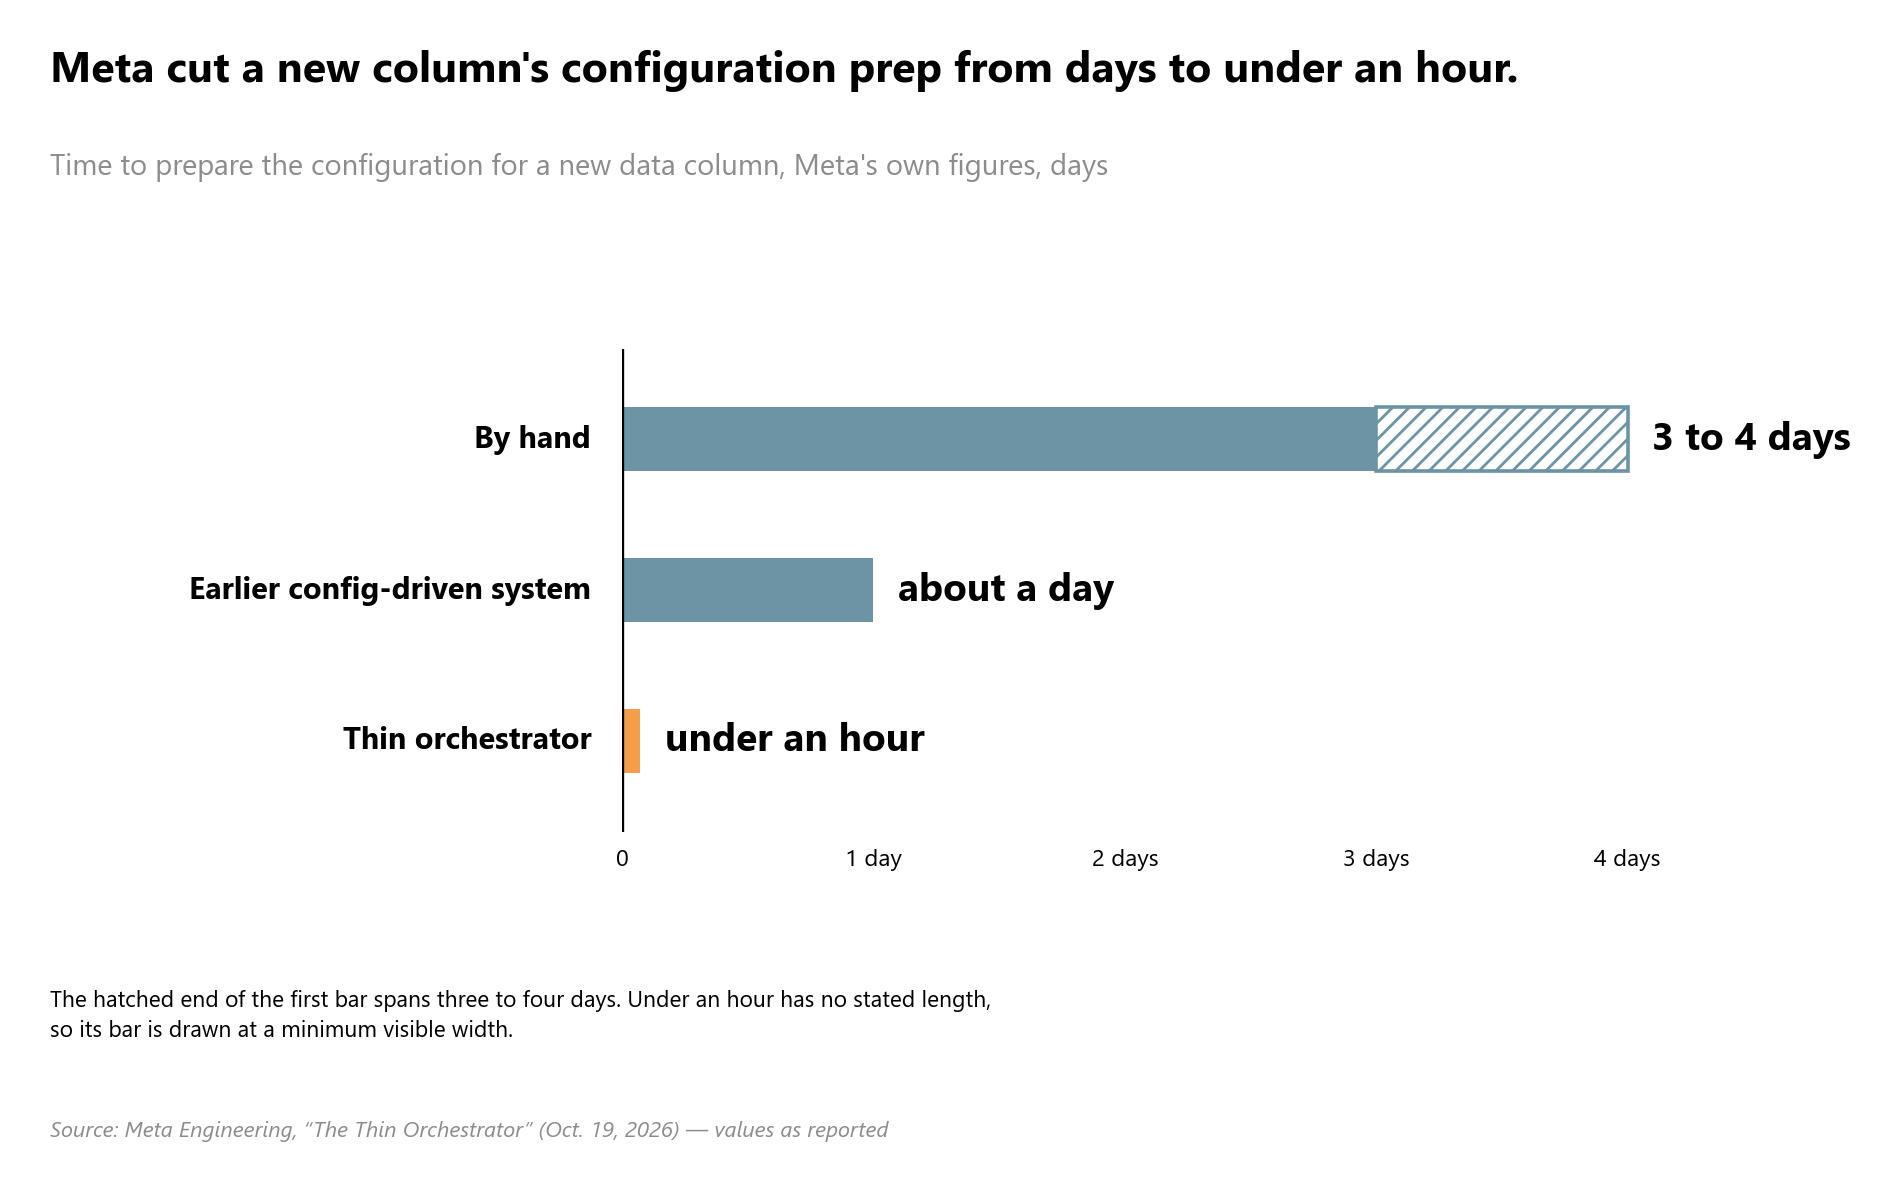
La réponse de Meta est un orchestrateur de 1 300 lignes qui aiguille plus de 20 flux de travail vers 14 agents spécialisés et n’effectue lui-même aucun travail métier. Chaque requête suit un protocole fixe en sept étapes. Les étapes un à cinq et l’étape sept sont déterministes, et seule l’étape six appelle un modèle de langage, à l’intérieur d’un unique spécialiste isolé. L’étape cinq est une barrière de fiabilité qui vérifie la présence d’alertes actives ou de relecteurs obligatoires. Meta indique que préparer la configuration d’une nouvelle colonne prenait trois à quatre jours à la main et environ un jour avec son précédent système piloté par configuration, et prend désormais moins d’une heure. Environ deux tiers des modifications du système sont intégrées sans retouche humaine significative. Ce sont les chiffres de Meta sur le système de Meta.
L’orchestrateur ne met pas le modèle à l’écart. Meta écrit qu’un meilleur modèle améliore simultanément les 14 sous-agents. Dans cette conception, c’est le code qui décide sur quoi le modèle travaille, et quand.
L’équipe Forum a appliqué la même logique à la vérification. Une tâche n’est terminée qu’une fois passés les tests automatisés et les contrôles visuels, et des crochets (hooks) lancent un analyseur de code (linter) après chaque tour de l’agent et valident les tests avant la création d’une demande de fusion (pull request). Chaque modification livrée porte toujours la validation d’un ingénieur, appuyée sur les résultats de compilation, les résultats des tests et les sessions de vérification enregistrées jointes à la modification. Ce que l’équipe peut confier sans risque à la boucle, écrit-elle, « est conditionné par la confiance que nous pouvons accorder aux vérificateurs ».
Le même schéma fonctionne pour un développeur seul. Geoffrey Huntley, cité par Willison, décrit ce qu’il fait quand un agent n’utilise pas sa bibliothèque de diagnostic. Mettre à jour AGENTS.md, le fichier d’instructions que lit l’agent, laisserait subsister un écart qui dérive ; il écrit donc un crochet de pré-validation (pre-commit hook) qui analyse le diff à la recherche d’appels directs aux modules d’observabilité, fait échouer la validation et injecte une instruction demandant à l’agent d’utiliser la bibliothèque. « Tout d’un coup, c’est dix sur dix. » Le crochet aboutit toujours à une instruction adressée au modèle, mais c’est désormais une règle écrite en code qui décide quand cette instruction se déclenche.
Quand le relecteur est un autre modèle
La seconde sorte de contrôle est un modèle qui relit le modèle. L’équipe Claude Code d’Anthropic (Addy Osmani, Morgan Westlee Lunt et Qing Wang, cités par Willison) tient la question de savoir si un humain a lu le code pour un indicateur imprécis de la vraie question : qu’est-ce qui pourrait mal tourner avec une modification, et quel contrôle, automatisé ou humain, est le bon pour le détecter. La relecture se fait désormais en continu, « davantage comme un correcteur orthographique pendant qu’on écrit », et la plupart des modifications ont été relues et corrigées par Claude au moins une fois avant qu’un humain soit sollicité. Selon l’équipe, cela intercepte la plupart des erreurs courantes et réserve son attention aux questions de plus haut niveau.
Le billet d’Anthropic sur la gestion de versions, là encore tel que le cite Willison, nomme une limite de la relecture par un modèle. L’entreprise recourt largement à la relecture contradictoire (adversarial review), que Willison, qui l’essaie dans ses propres projets, décrit comme le fait de demander à un modèle de chercher des failles. Anthropic la juge extrêmement efficace à bien des égards, mais elle peut aussi avoir la vue courte : des ingénieurs expérimentés ont dû détourner Claude de la tentation de surconcevoir certaines parties du système en réponse à des inquiétudes hypothétiques.
Le rapport d’Anthropic sur ses effectifs montre où est passé le travail humain restant. Dans une enquête d’avril 2026, 20 % des salariés ont déclaré que leur poste était passé « de faire réellement le travail à gérer des Claude ». Le temps de réunion par salarié a augmenté de 20 % en un an, et de 16 % pour les contributeurs techniques, ce qu’Anthropic attribue à l’importance de la confiance et de la responsabilité humaines. Sur la qualité, Anthropic reconnaît que plus de code ne signifie pas nécessairement un meilleur code, mais dit n’avoir trouvé aucun indice d’une baisse de la qualité du code. Ce constat est celui d’Anthropic, sur son propre code.
Ce que cela signifie
Lus ensemble, les récits de la semaine décrivent un contrôle qui entre dans la boucle au lieu d’attendre à sa sortie. Les plus concrets de ces contrôles sont écrits en code ou joints à la modification : tests, crochets, barrières d’aiguillage, preuves de vérification jointes à la demande de fusion. L’équipe Forum de Meta qualifie son propre modèle de supervision humaine de la boucle (human-on-the-loop) d’« objectif vers lequel nous avançons, pas un état achevé ».
La question ouverte est de savoir si la vérification suit le rythme du volume. Un nombre de fusions mesure un débit, pas la file d’attente qui se forme derrière. Pour une équipe qui adopte des agents, les chiffres qui méritent d’être instrumentés sont le temps d’attente des modifications avant relecture humaine, la part de celles qu’un modèle seul approuve, et la fréquence à laquelle une modification qui avait passé ses contrôles se révèle fausse par la suite. Bain pousse la même question vers l’exploitation et recommande de reconstruire la mesure pour que la confiance et le contrôle soient visibles à côté de la vitesse.
La question la plus difficile est de savoir d’où vient le jugement. Chez Anthropic, la part des salariés juniors dans les départements techniques est passée de 21 % à 14 % depuis le début de 2025, et la part des juniors dans les recrutements techniques de 27 % à 9 %. C’est un seul employeur, qui vend en outre l’outil, et TechCrunch ne rapporte aucune cause à cette baisse. Si la vérification devient le cœur du métier, il faudra pourtant que le secteur dise où les ingénieurs apprennent à vérifier.
Nous avions d’abord examiné l’écart entre générer et vérifier dans Lean Checks OpenAI’s Proofs; Humans Miss 1 Agent Threat in 3, et l’environnement qui entoure les modèles, le harnais (harness), dans OpenAI’s Own Guide Puts 25 Benchmark Points in the Harness. Le code applicatif ordinaire n’a pas d’équivalent de Lean pour trancher si une demande de fusion fait ce dont l’entreprise a besoin, et les récits de cette semaine montrent des équipes qui reconstruisent le harnais pour vérifier ce que produit l’agent.
Sources
- Redesigning source control at Anthropic (Simon Willison)
- Quoting Addy Osmani, Morgan Westlee Lunt, and Qing Wang (Simon Willison)
- Quoting Geoffrey Huntley (Simon Willison)
- How Meta Built Forum With AI-Native Engineering (Meta Engineering)
- The Thin Orchestrator: How We Made Our AI Agents More Reliable by Giving the Router Less to Do (Meta Engineering)
- Getting real about AI: How AI agents are changing the economics of software engineering (McKinsey Insights)
- Anthropic says its workforce has become less junior and is spending more time in meetings (TechCrunch)
- AI in Software Engineering: The Reliability Paradox (Bain)
- Advancing coding in low-resource programming languages (OpenAI)
- Lean Checks OpenAI’s Proofs; Humans Miss 1 Agent Threat in 3 (Count2Three)
- OpenAI’s Own Guide Puts 25 Benchmark Points in the Harness (Count2Three)