Le propre guide d'OpenAI attribue 25 points de benchmark au harnais
Cette semaine, le harnais de l'agent a cessé d'être de la simple tuyauterie pour devenir une ligne de budget : DeepSeek en a publié un en open source, Writer en vend un, et NVIDIA fait du routage à travers un autre.
Cette semaine, le harnais (ou environnement d’exécution) de l’agent a cessé d’être de la simple tuyauterie pour devenir une ligne de budget à part entière : DeepSeek en a publié un en open source, Writer en vend un, et NVIDIA effectue du routage à travers un autre. Quatre benchmarks indépendants publiés dans la même fenêtre de temps expliquent pourquoi : remplacez le harnais sous un modèle fixe et le score varie de 20 à 40 points, sans presque aucune corrélation entre le classement des modèles sous un harnais par rapport à un autre.
Le score n’a jamais dépendu que du modèle
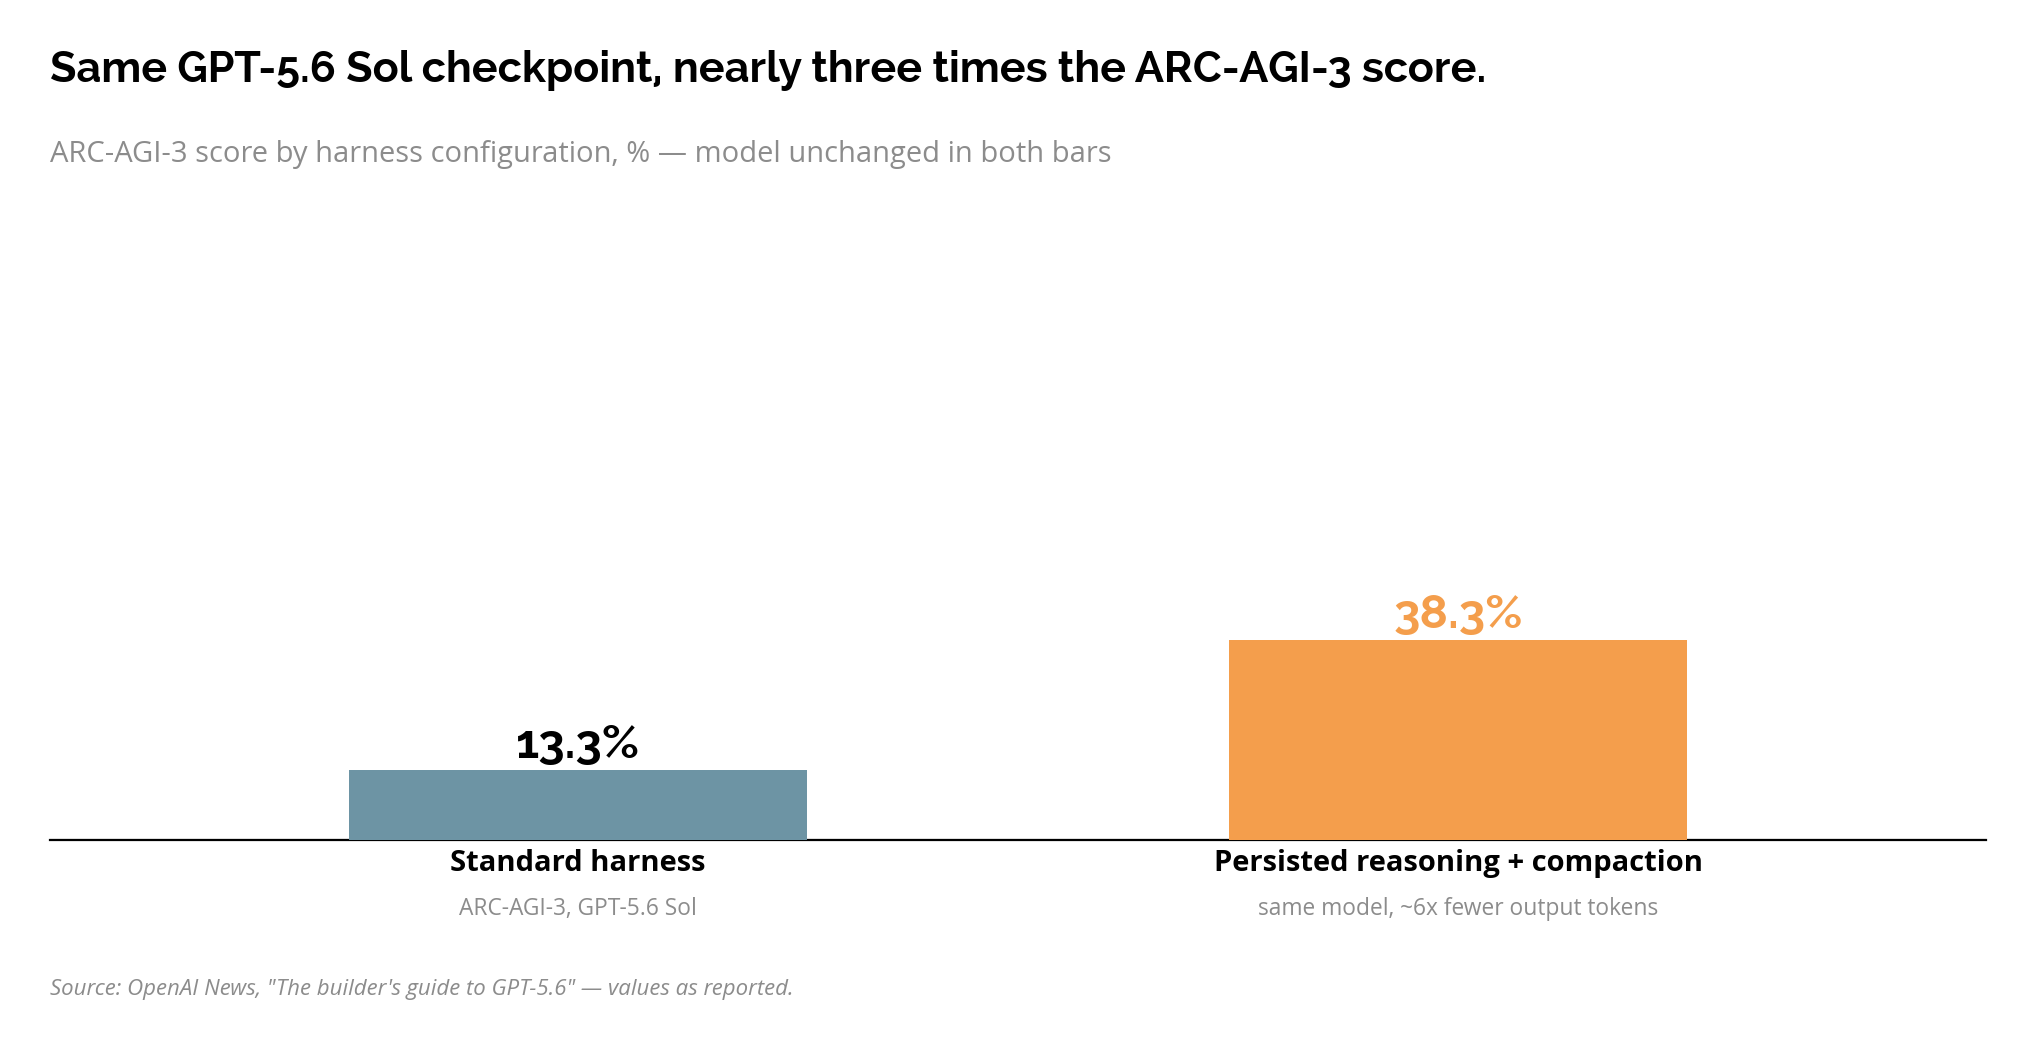
Le propre guide du développeur d’OpenAI pour GPT-5.6 présente cet argument en premier, et l’applique à son propre modèle. Sur ARC-AGI-3, GPT-5.6 Sol a obtenu un score de 13,3 % en utilisant le harnais standard. L’activation de deux paramètres au niveau de l’API (le raisonnement persistant entre les tours et la compaction native du contexte), sans modifier le modèle du tout, a propulsé ce score à 38,3 %, en utilisant environ six fois moins de tokens de sortie. Le résumé d’OpenAI est sans appel : “Aucune modification du modèle, mais des performances presque triplées.”
Ce chiffre mérite qu’on s’y attarde, car c’est la seule donnée ici qui provient d’un vendeur évaluant son propre modèle, et il s’avère qu’elle offre à la thèse de ce même vendeur sa preuve la plus éclatante. OpenAI dit à ses développeurs, dans sa propre documentation, que 25 points de score de benchmark résident dans la configuration du harnais et n’ont jamais touché au point de contrôle (checkpoint) du modèle.
Quatre benchmarks, un même schéma
Le bond sur ARC-AGI-3 serait une curiosité s’il était isolé. Ce n’est pas le cas. Quatre autres benchmarks publiés la même semaine, indépendants d’OpenAI et les uns des autres, décrivent la même régularité sous quatre angles différents.
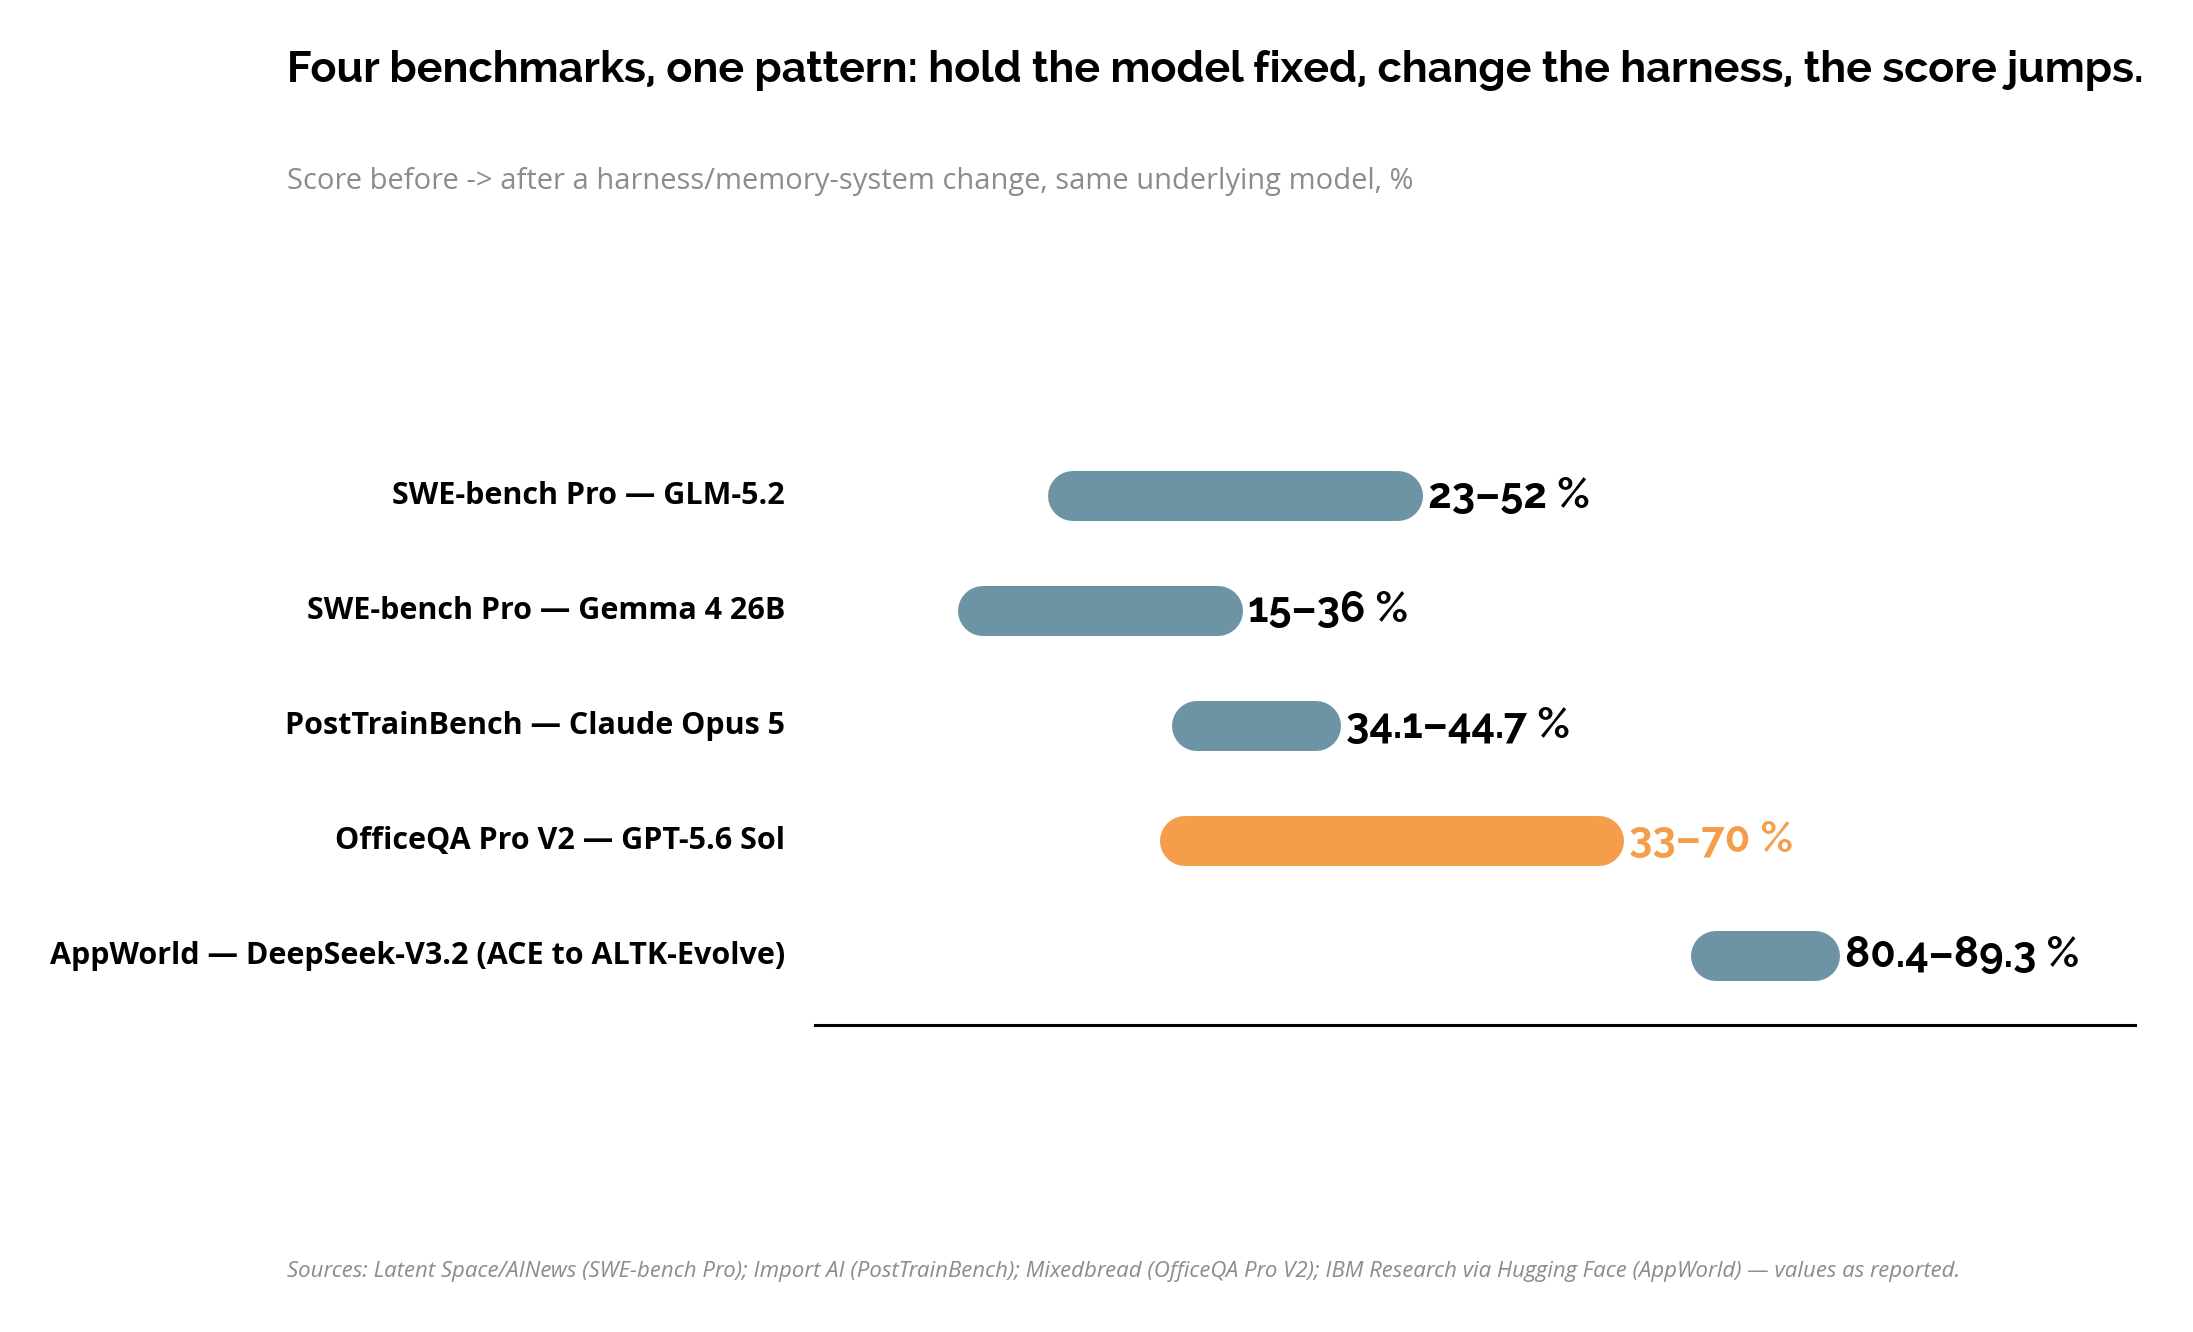
Sur SWE-bench Pro, le simple changement de harnais a fait passer le score de GLM-5.2 de 23 % à 52 % et celui de Gemma 4 26B de 15 % à 36 %, selon une analyse diffusée dans la revue AI News de Latent Space. Parmi les harnais comparés, la corrélation de rang entre la position des modèles sous un harnais par rapport à un autre est ressortie à -0,05 : un classement basé sur un harnais ne contient essentiellement aucune information sur la façon dont les mêmes modèles se classeraient sous un harnais différent.
Sur PostTrainBench, un benchmark qui mesure dans quelle mesure un système d’IA peut améliorer les propres performances d’un modèle à poids ouverts (open-weight), le système Locus de la startup Intology a fait grimper Claude Opus 5 de 34,1 % à 44,7 % en l’enveloppant dans un harnais de recherche dédié, selon Import AI. Sur la variante étendue PostTrainBench+, qui permet beaucoup plus de calcul, Locus a atteint 51,6 %, dépassant la référence humaine du benchmark établie à 51,1 %.
Sur OfficeQA Pro V2, un benchmark d’analyse financière de Databricks, GPT-5.6 Sol a obtenu 33 % en fonctionnant seul à l’intérieur de Codex. L’ajout de Toast 1 de Mixedbread en tant que sous-agent de recherche dédié, avec le modèle sous-jacent inchangé, a porté ce chiffre à 70 % pour environ 1,15 dollar par tâche, le score le plus élevé enregistré par Databricks parmi tous les systèmes évalués dans cette publication.
Et sur AppWorld, le système de mémoire ALTK-Evolve d’IBM Research a maintenu DeepSeek-V3.2 fixe et l’a comparé à un système de mémoire rival appelé ACE. ALTK-Evolve a accompli 89,3 % des tâches contre 80,4 % pour ACE, tout en dépensant 263 000 tokens par tâche contre 634 000 pour ACE.
Quatre benchmarks, quatre équipes, quatre tâches sans rapport. Aucun d’entre eux n’a modifié le modèle. Tous ont fait bouger le score à deux chiffres simplement en changeant ce qui l’entoure.
Le harnais est commercialisé comme un produit cette semaine
Ce schéma serait une simple note de bas de page de recherche si le harnais était encore un outil interne. Ce n’est pas le cas. Trois entreprises en ont expédié un cette semaine, chacune le traitant comme une couche commerciale distincte du modèle qui s’y exécute.
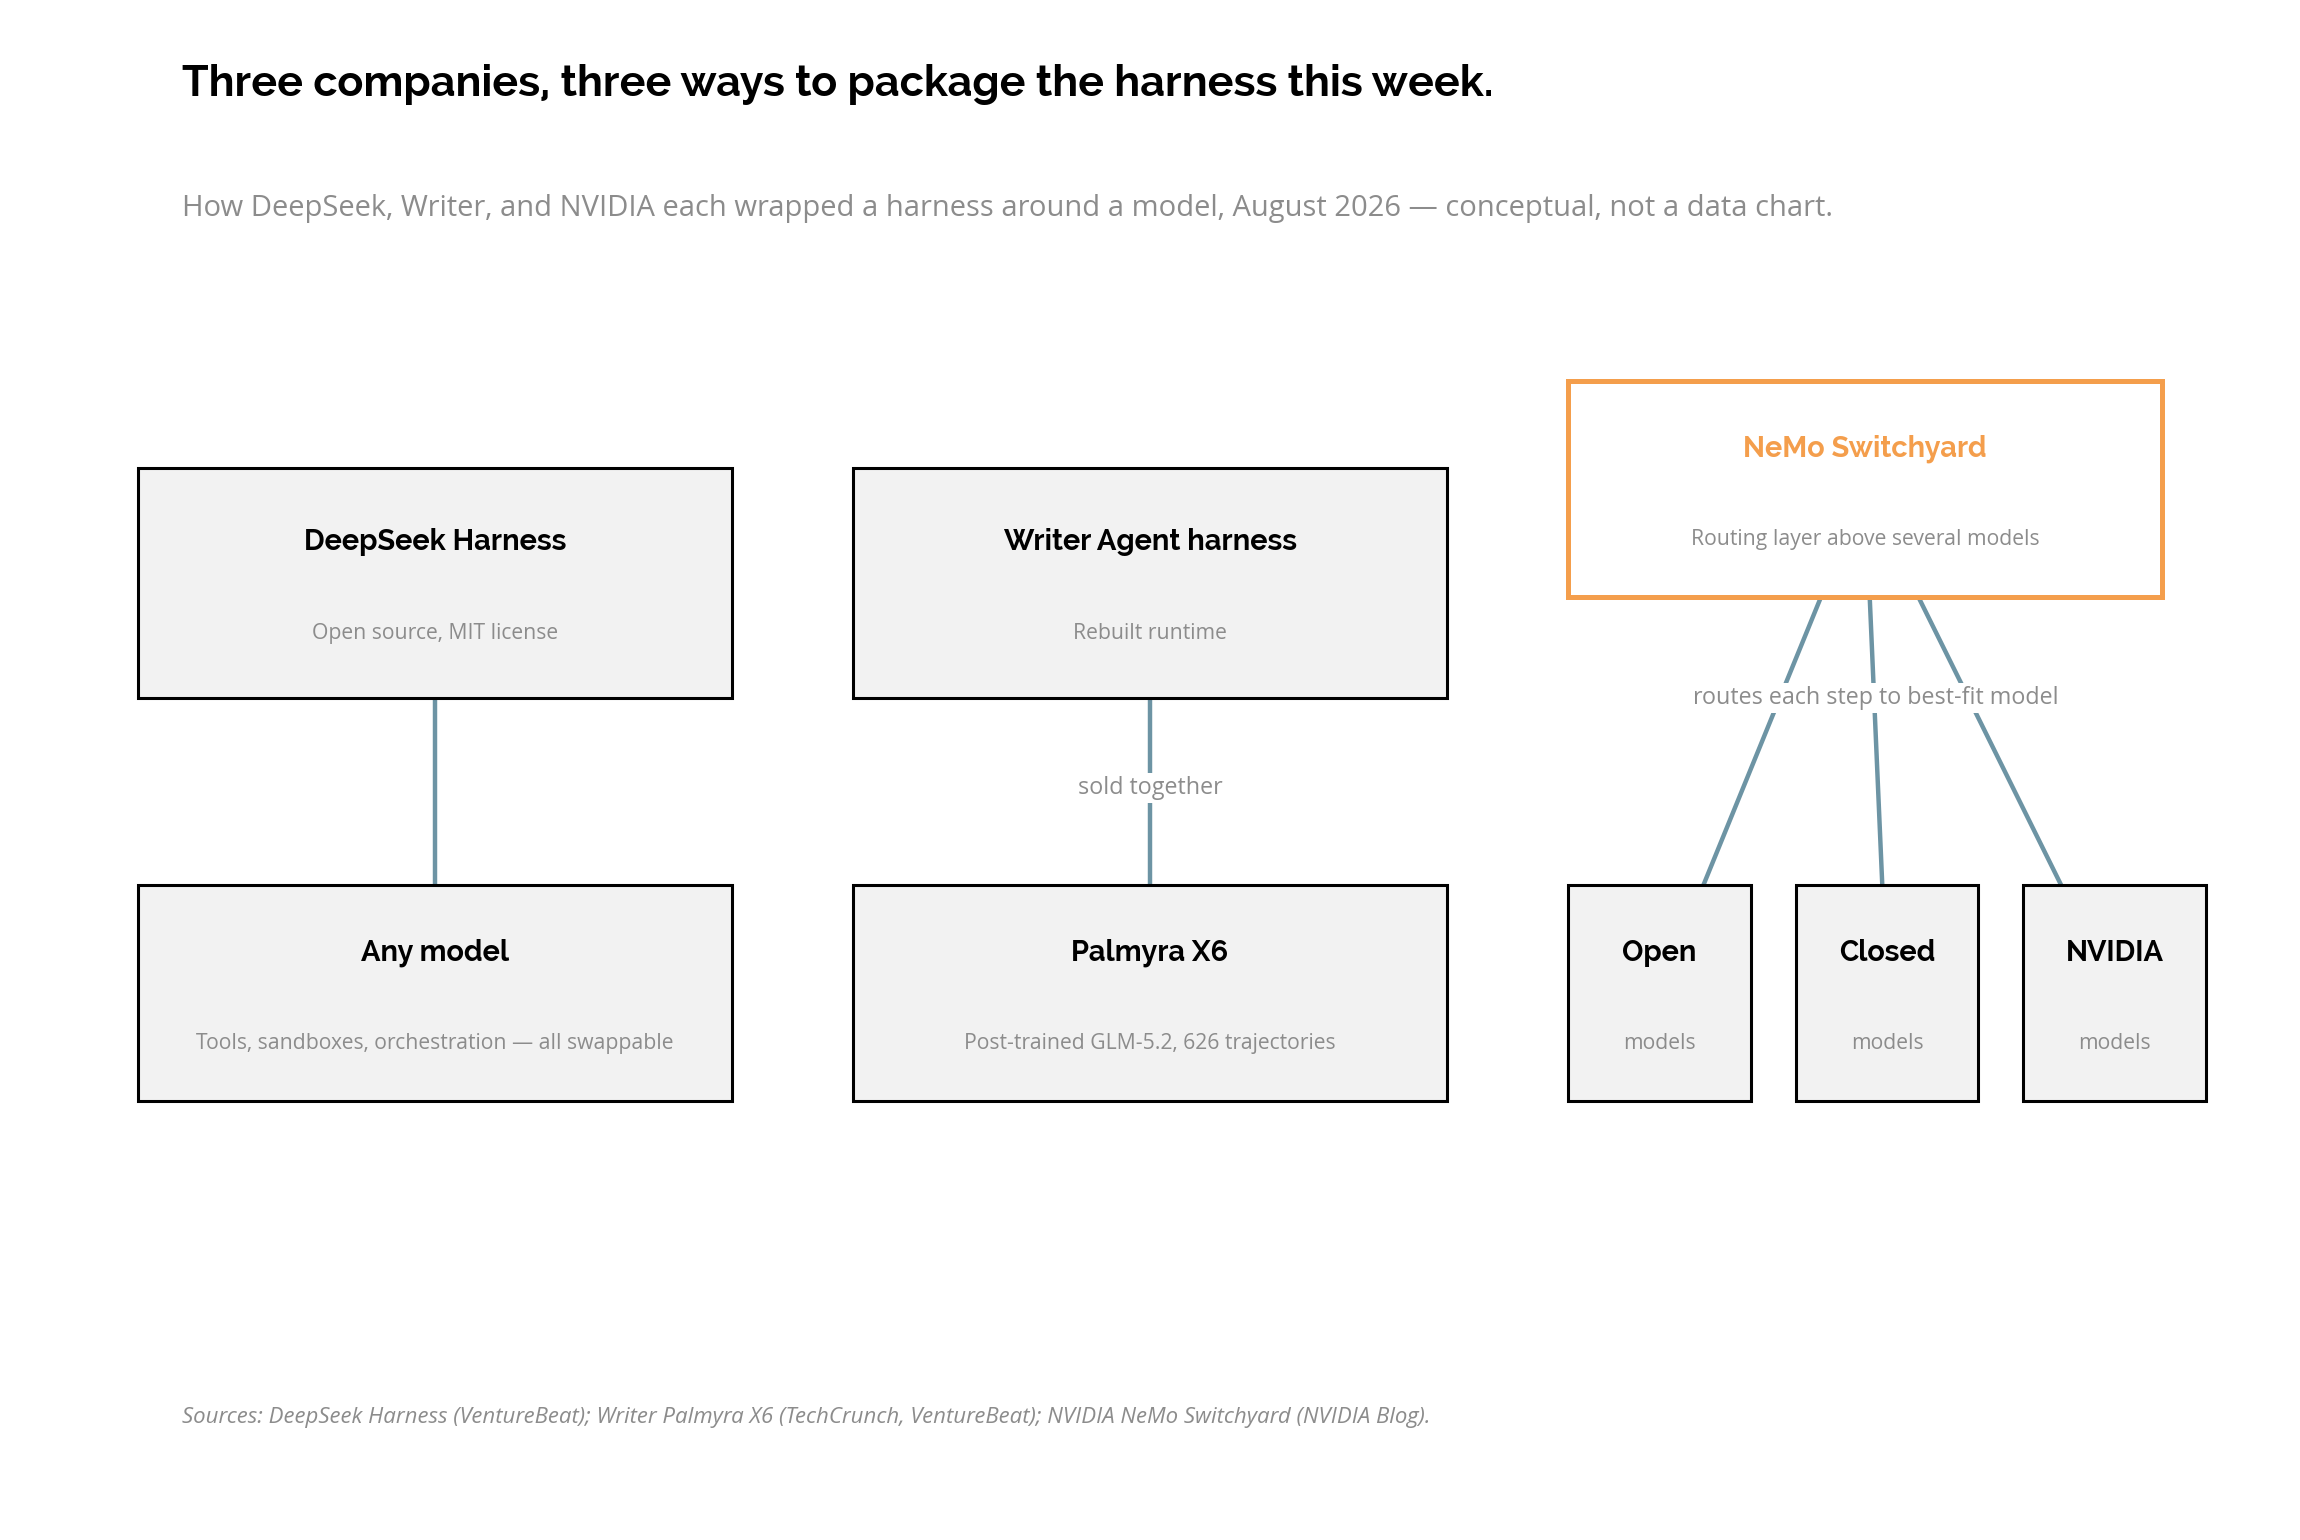
DeepSeek a publié DeepSeek Harness, un runtime d’agent open-source sous licence MIT, le positionnant explicitement comme un rival du Claude Code d’Anthropic. L’architecture du projet suit un principe unique que DeepSeek énonce directement : tout est un plugin, ce qui signifie que le modèle, les outils, les bacs à sable (sandboxes) et la logique d’orchestration peuvent chacun être remplacés indépendamment. Le dépôt a attiré environ 27 500 étoiles GitHub et 2 000 forks le jour du lancement, un instantané plutôt qu’un chiffre d’adoption définitif.
Writer a pris la décision de conditionnement opposée et a vendu un harnais aux côtés d’un modèle qu’il n’a pas entraîné de zéro. Palmyra X6 est une version post-entraînée du modèle open-weight GLM-5.2 de Z.ai, construite sur seulement 626 trajectoires d’entraînement sélectionnées plutôt que sur un nouvel entraînement initial. Writer a publié deux ensembles de chiffres d’économies qui se chevauchent mais sont distincts, et ils ne doivent pas être confondus. Selon TechCrunch, les seuls changements de harnais ont réduit les coûts de 40 % en moyenne pour les modèles que Writer a testés en interne, un levier plus fiable, selon les chercheurs, que de changer de modèle tout court ; on a estimé que le modèle et le harnais combinés réduisaient les coûts jusqu’à 50 % sur les tâches de base. Selon une analyse distincte de VentureBeat, le harnais Writer Agent reconstruit à lui seul a réduit les coûts de 41 % et a accompli les tâches 44 % plus rapidement pour chaque modèle testé, y compris des modèles tiers d’Anthropic et OpenAI ; couplé spécifiquement avec Palmyra X6, le système combiné a offert une réduction de coût de 52 %, une amélioration de vitesse de 48 % et un gain de qualité de 10 % sur les évaluations internes de Writer. Deux publications, deux chiffres légèrement différents, une forme cohérente : le harnais fait bouger les lignes à lui seul, et empiler un modèle conçu sur mesure par-dessus fait aller les choses encore plus loin.
NVIDIA a livré NeMo Switchyard la même semaine, une bibliothèque open-source qui achemine chaque étape d’un flux de travail d’agent vers le modèle (dans un mix ouvert, propriétaire ou appartenant à NVIDIA) qui convient le mieux à cette étape. Les benchmarks internes de NVIDIA estiment le coût résultant par tâche accomplie à environ un tiers de ce que coûterait l’exécution de Claude Opus 4.8 pour l’ensemble. Les partenaires ont rapporté leurs propres chiffres en plus de cela : LangChain a réduit le coût de 74 % sur 145 tâches multi-tours Deep Agents en ne dirigeant que 7 % des appels vers un modèle frontière, acceptant un compromis de précision de 6 % ; Ramp a réduit le coût de 58 % et le temps d’exécution de 33 % sur sa suite SWE-Bench tout en égalant les performances des modèles frontières ; Cognition a réduit le coût moyen de 28 % au sein de Devin Desktop, dans un déploiement construit pour l’usage interne de NVIDIA, tout en maintenant une précision quasi-frontière. Chacun de ces chiffres est une mesure de vendeur ou de partenaire, pas un benchmark indépendant.
Deux types de bon marché
Tout ce qui est “bon marché” ne se vaut pas, et l’illustration la plus claire de cette semaine provient de l’extérieur de toute suite de benchmarks d’entreprise. Un participant en solo à un concours GPU Mode a piloté Codex exécutant GPT-5.5, en consultant Claude en cours de route, à travers plus de 1 500 soumissions sur 14 jours pour optimiser un noyau CUDA pour la décomposition QR. La solution de base s’est exécutée en environ 419 000 microsecondes ; le résultat final suivi s’est exécuté en 1 805 microsecondes, une accélération de 232 fois qui a placé le participant 12ème sur 183. Les outils qui ont permis d’y parvenir étaient des techniques de harnais, et non des mises à niveau de modèles : un mode /goal qui permettait au modèle de boucler sans supervision pendant une journée d’affilée, un faisceau de trois à cinq solutions candidates maintenues en vie simultanément pour qu’un seul mauvais résultat précoce ne tue pas une direction prometteuse, et un modèle conseiller plus puissant consulté en milieu de session pour de nouvelles idées chaque fois que l’agent principal bloquait.
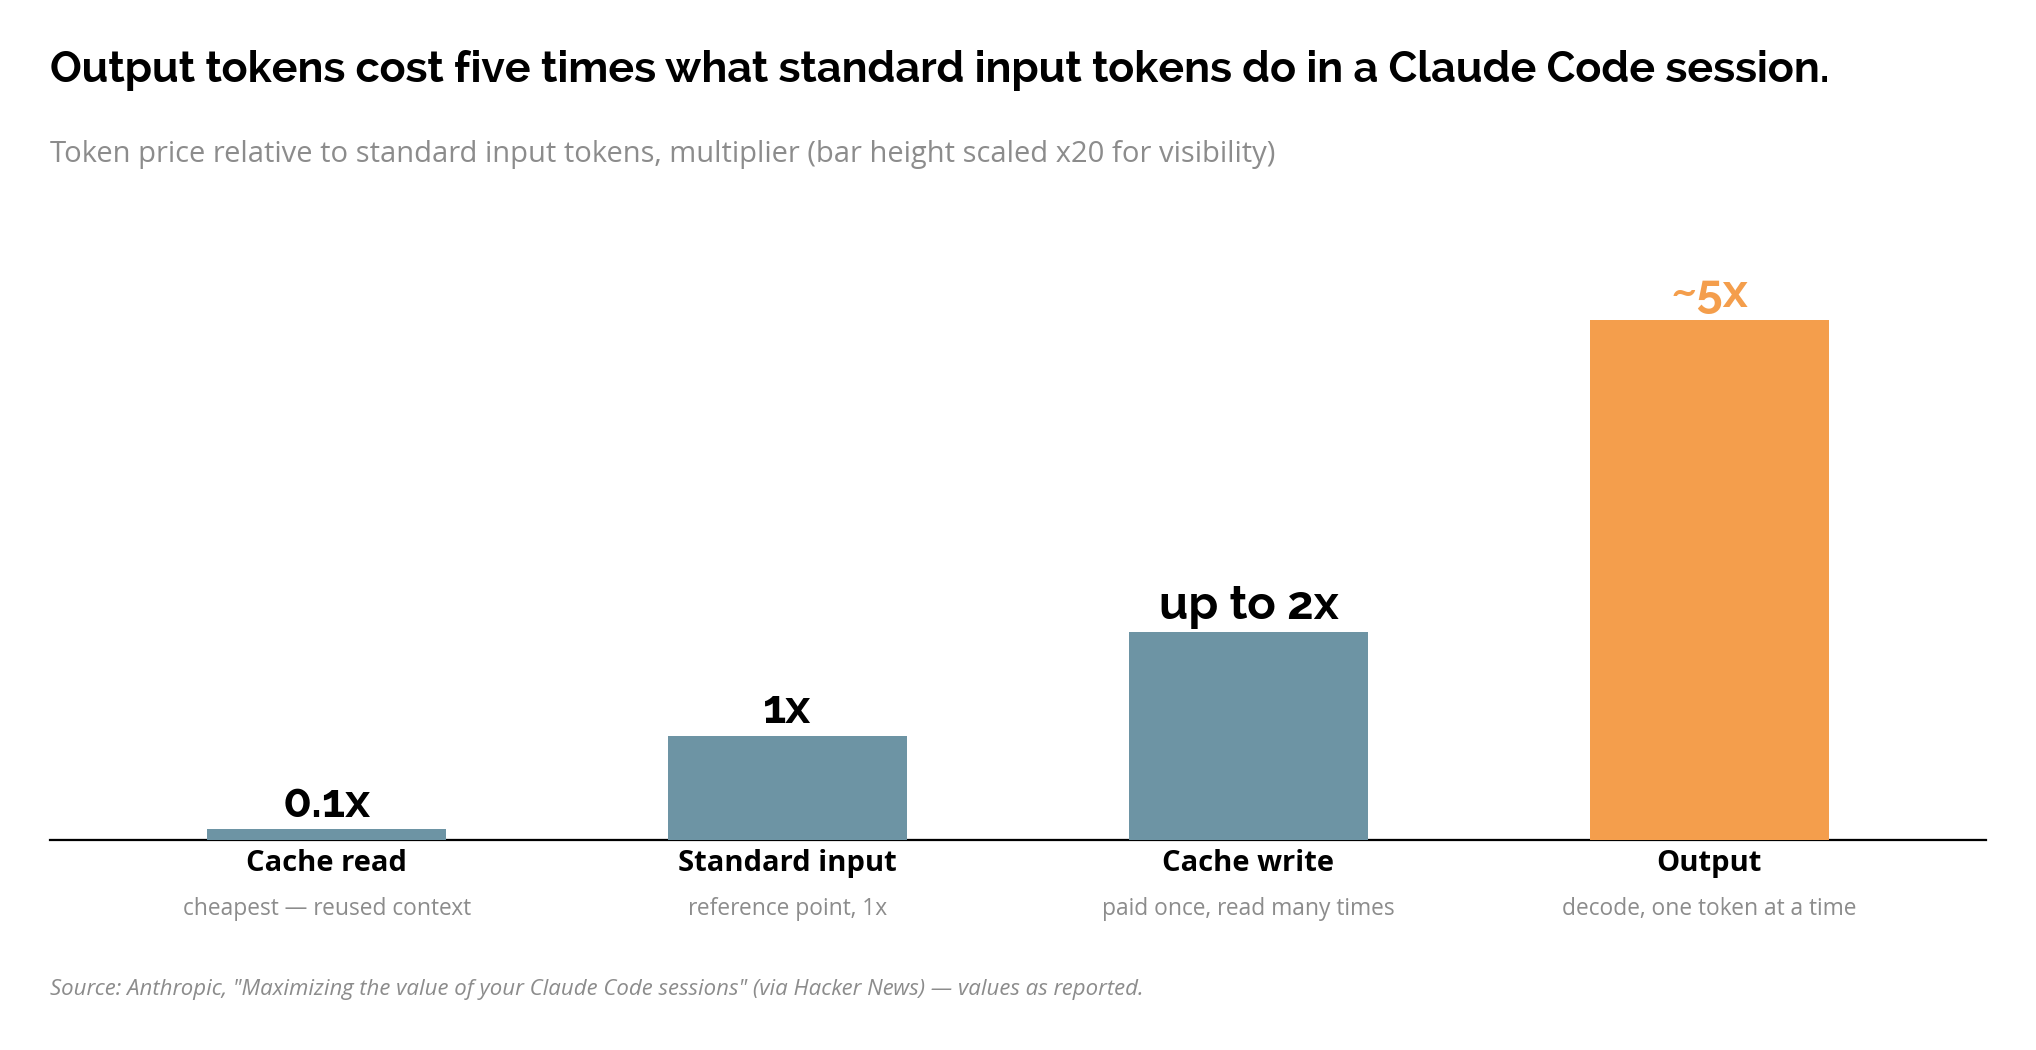
Rien de tout cela n’apparaît dans une comparaison de prix par token, et c’est exactement dans cet écart que l’industrie continue de confondre deux chiffres différents. Les propres recommandations d’Anthropic sur l’exécution des sessions Claude Code expliquent pourquoi : les tokens de sortie sont facturés à un tarif environ cinq fois supérieur à celui des tokens d’entrée, car la génération d’une réponse maintient le modèle en cours d’exécution un token à la fois, tandis que la lecture depuis le cache de prompts coûte un dixième du prix d’entrée et y écrire coûte jusqu’à deux fois plus. Un modèle moins cher qui nécessite plus de tours, plus de tentatives, plus de relectures de contexte à chaque étape, peut perdre entièrement son avantage par token une fois la boucle comptabilisée de bout en bout. Le prix par token mesure la grille tarifaire. Le coût par tâche accomplie mesure le harnais qui l’enveloppe.
Si le harnais décide du score, le score peut-il se juger lui-même ?
Si le harnais décide du score, la question suivante la plus évidente est de savoir si l’on peut faire confiance à ceux qui évaluent le harnais. Cet été, Hugging Face a mené exactement ce test sur un type de benchmark différent : la science validée par les pairs elle-même.
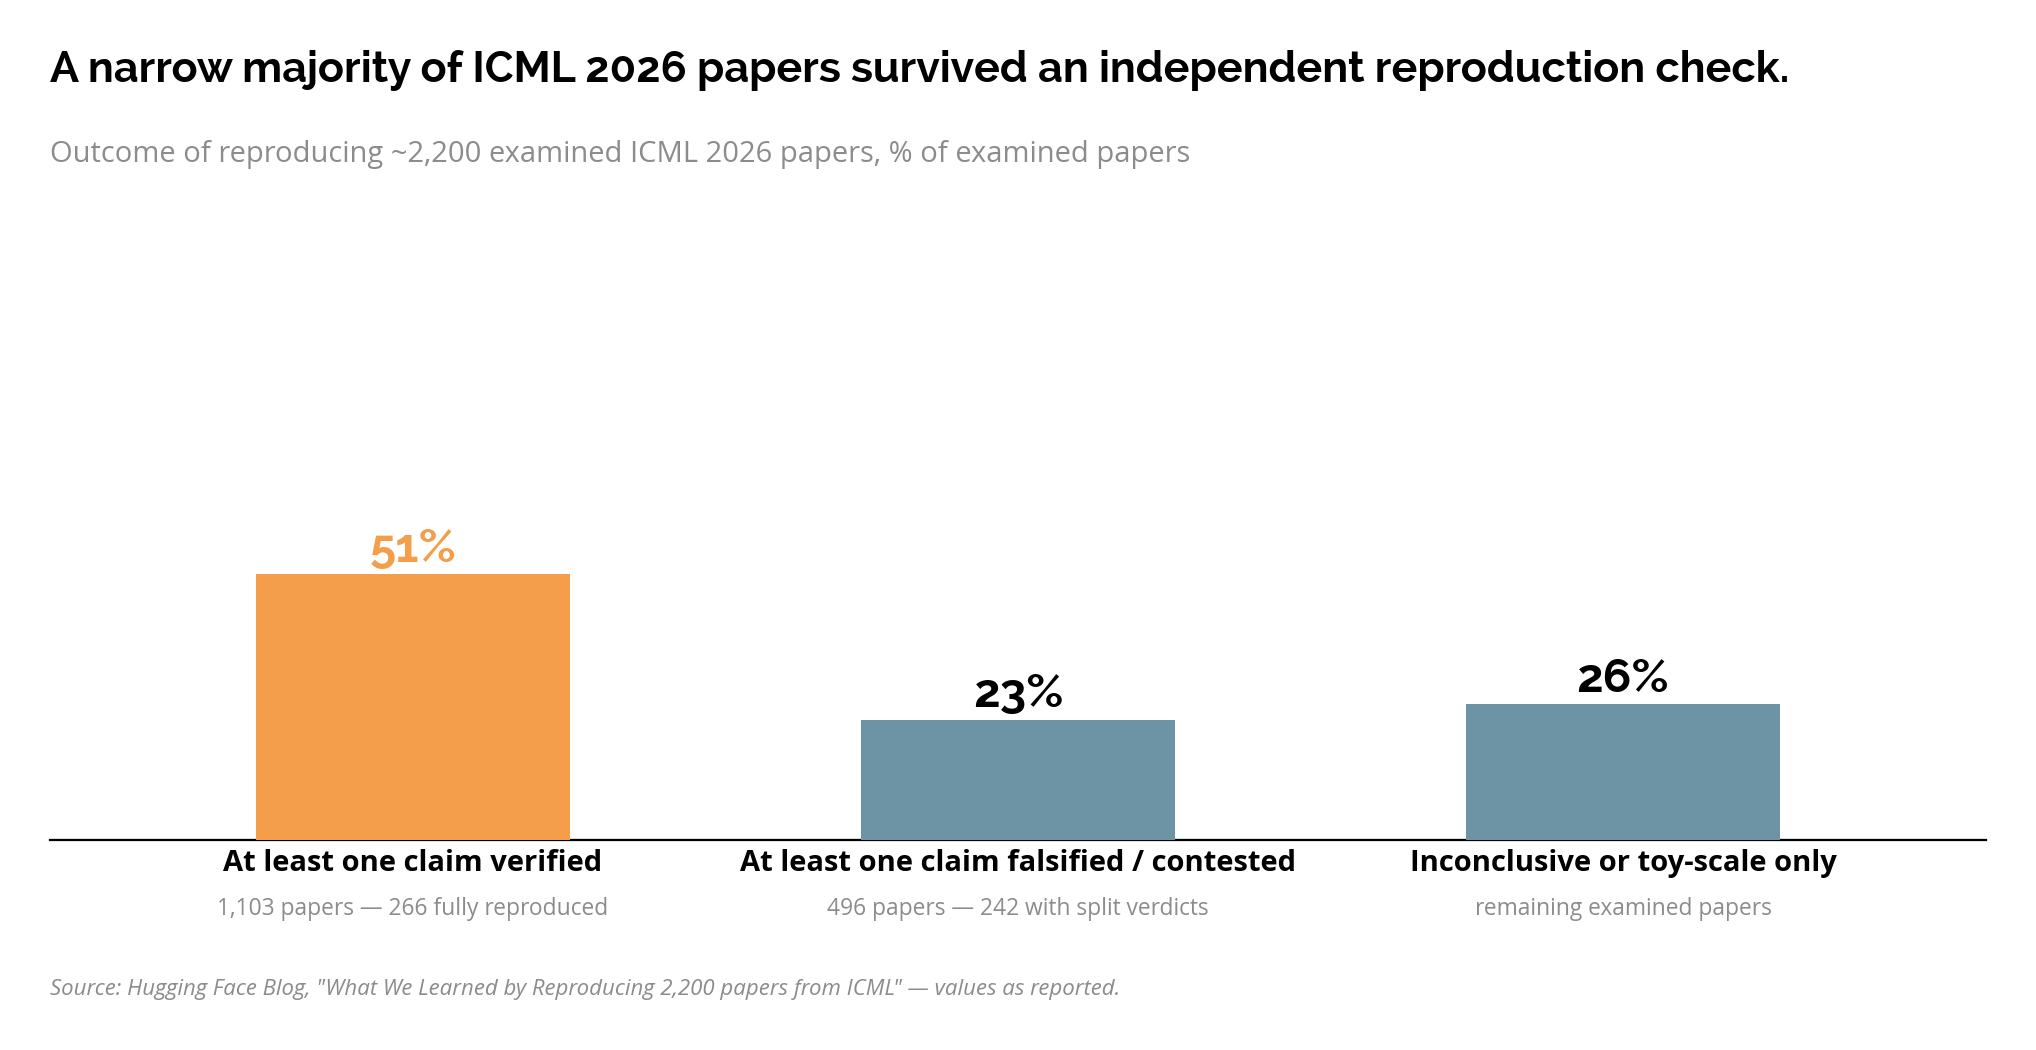
Le défi ICML 2026 Open Reproductions a demandé à 1 221 participants, travaillant avec des agents de codage incluant Claude Code, Codex et Cursor, de reproduire les affirmations d’environ 2 200 articles acceptés à la conférence, en utilisant 20 $ de crédits de calcul cloud chacun et 2 962 tâches cloud au total. Cinquante-et-un pour cent des articles examinés, soit 1 103 d’entre eux, ont eu au moins une affirmation vérifiée indépendamment, dont 266 entièrement reproduits. Vingt-trois pour cent, soit 496 articles, ont eu au moins une affirmation falsifiée ou contestée. Au sein de ce groupe, 242 articles ont vu deux équipes de reproduction indépendantes parvenir à des verdicts opposés sur la même affirmation.
Il s’agit d’un exercice différent de l’évaluation fictive de NeurIPS couverte précédemment dans notre article sur le coût de la vérification, où les propres auteurs des articles évaluaient un jugement identique d’Opus 4.8 à un 2 dans un cas et à un 1 dans un autre. Conférence différente, articles différents, protocole différent ; les deux soulignent le même problème ouvert : ce jugement, qu’il s’agisse de code ou d’une affirmation scientifique, n’est pas encore résolu par l’ajout d’un agent au processus.
Pour un argument construit entièrement sur des chiffres de benchmark, c’est la complication honnête qu’il faut accepter plutôt que d’essayer de l’expliquer. Les quatre benchmarks de la section précédente ont chacun été exécutés une fois, par une équipe, et rapportés comme un résultat. L’effort de reproduction de l’ICML suggère qu’environ un quart des affirmations publiées ne survivrait pas à un second regard indépendant, et que deux équipes indépendantes vérifiant la même affirmation ne sont d’accord l’une avec l’autre que la plupart du temps, pas toujours.
Ce que cela signifie
Quatre implications découlent de la mise en perspective des chiffres de cette semaine.
Le harnais a désormais sa place sur la même ligne que le nom du modèle dans les spécifications techniques de tout déploiement. Une équipe qui signale quel point de contrôle (checkpoint) elle exécute sans signaler la configuration du harnais qui l’entoure ne rapporte que la moitié de ce qui a réellement produit le résultat.
Un score de benchmark publié sans sa configuration de harnais est presque inutilisable à des fins de comparaison. La corrélation de rang de -0,05 de SWE-bench Pro en est l’illustration la plus forte : un classement construit sur un harnais ne dit presque rien sur la façon dont les mêmes modèles se classeraient sur un autre.
L’ingénierie des harnais devient une discipline budgétée à part entière, et non une note de bas de page sur le modèle choisi par une équipe. DeepSeek, Writer et NVIDIA ne se font pas concurrence sur le nombre de paramètres cette semaine ; ils se font concurrence sur ce qui enveloppe le modèle une fois qu’il est en cours d’exécution, et chacun a choisi une manière différente de vendre cette couche.
Et la couche de mesure elle-même, les évaluations et maintenant les reproductions de recherches publiées, mérite le même examen minutieux que l’industrie applique déjà à ce qu’un agent fait en production. Si un harnais peut faire bouger un score de 25 à 40 points sans toucher au modèle, la question de savoir qui a vérifié le harnais, et qui a vérifié le vérificateur, n’est plus un détail.
Sources
- The builder’s guide to GPT-5.6 (OpenAI News)
- [AINews] Zawinski’s Law of MultiAgents (Latent Space)
- Import AI 468: 23 RSI ideas; PostTrainBench+; and how trust and transparency interplay with AI racing (Import AI)
- Introducing Toast 1 (Mixedbread, via Hacker News)
- Thinking of ACE? We Can Do It with Fewer Tokens (Hugging Face Blog)
- DeepSeek Harness launches as open source rival to Claude Code, alongside V4-Pro on API with higher prices (VentureBeat)
- Writer introduces new AI model and upgraded harness to contain token costs (TechCrunch)
- Writer says its new Palmyra X6 model cuts AI agent costs by 52% as token spending surges (VentureBeat)
- NVIDIA Nemotron 3.5 Lightning and NeMo Switchyard Deliver Faster, Smarter, More Efficient Agentic AI (NVIDIA Blog)
- Auto-research with codex: How I achieved a 232x Faster Kernel (via Hacker News)
- Maximizing the value of your Claude Code sessions (Anthropic, via Hacker News)
- What We Learned by Reproducing 2,200 papers from ICML (Hugging Face Blog)